Airflow 하면 DAG라는 용어가 자주 나옵니다. 그런데 처음 공부할 때는 정작 DAG가 뭔지, 그냥 cron으로 스크립트를 돌리는 것과 뭐가 그렇게 다른지 잘 와닿지 않았습니다. 《Apache Airflow 기반의 데이터 파이프라인》 1장은 바로 이 질문에 답하는 장입니다.
 이 글에서 알아갈 수 있는 것
- Airflow 하면 자주 나오는 DAG, 도대체 뭘까?
- cron으로 스크립트를 돌리는 것과 뭐가 다를까? cron(정해진 시간에 명령을 실행하는 도구)으로 스크립트 하나를 돌리면 처음부터 끝까지 순서대로 한 번에 돕니다. Airflow는 작업을 여러 태스크로 나눠 필요한 부분만 따로 실행할 수 있습니다.
- Airflow 안에서는 누가 무엇을 할까? (스케줄러·워커·메타스토어·웹 서버)
- Airflow는 왜 배치용이고, 실시간(스트리밍)에는 맞지 않을까?
- 책은 Airflow 2.0 기준인데, 지금의 Airflow 3에서는 무엇이 달라졌을까?
1장은 Airflow를 '거미줄의 거미’에 비유하며 시작합니다. 거미가 줄로 이어진 곳곳을 살피듯, Airflow는 여러 (분산) 시스템에서 일어나는 작업을 조율합니다. 데이터 처리를 직접 하기보다는, 데이터 처리를 맡은 여러 구성 요소를 조정하는 역할이라는 뜻입니다.
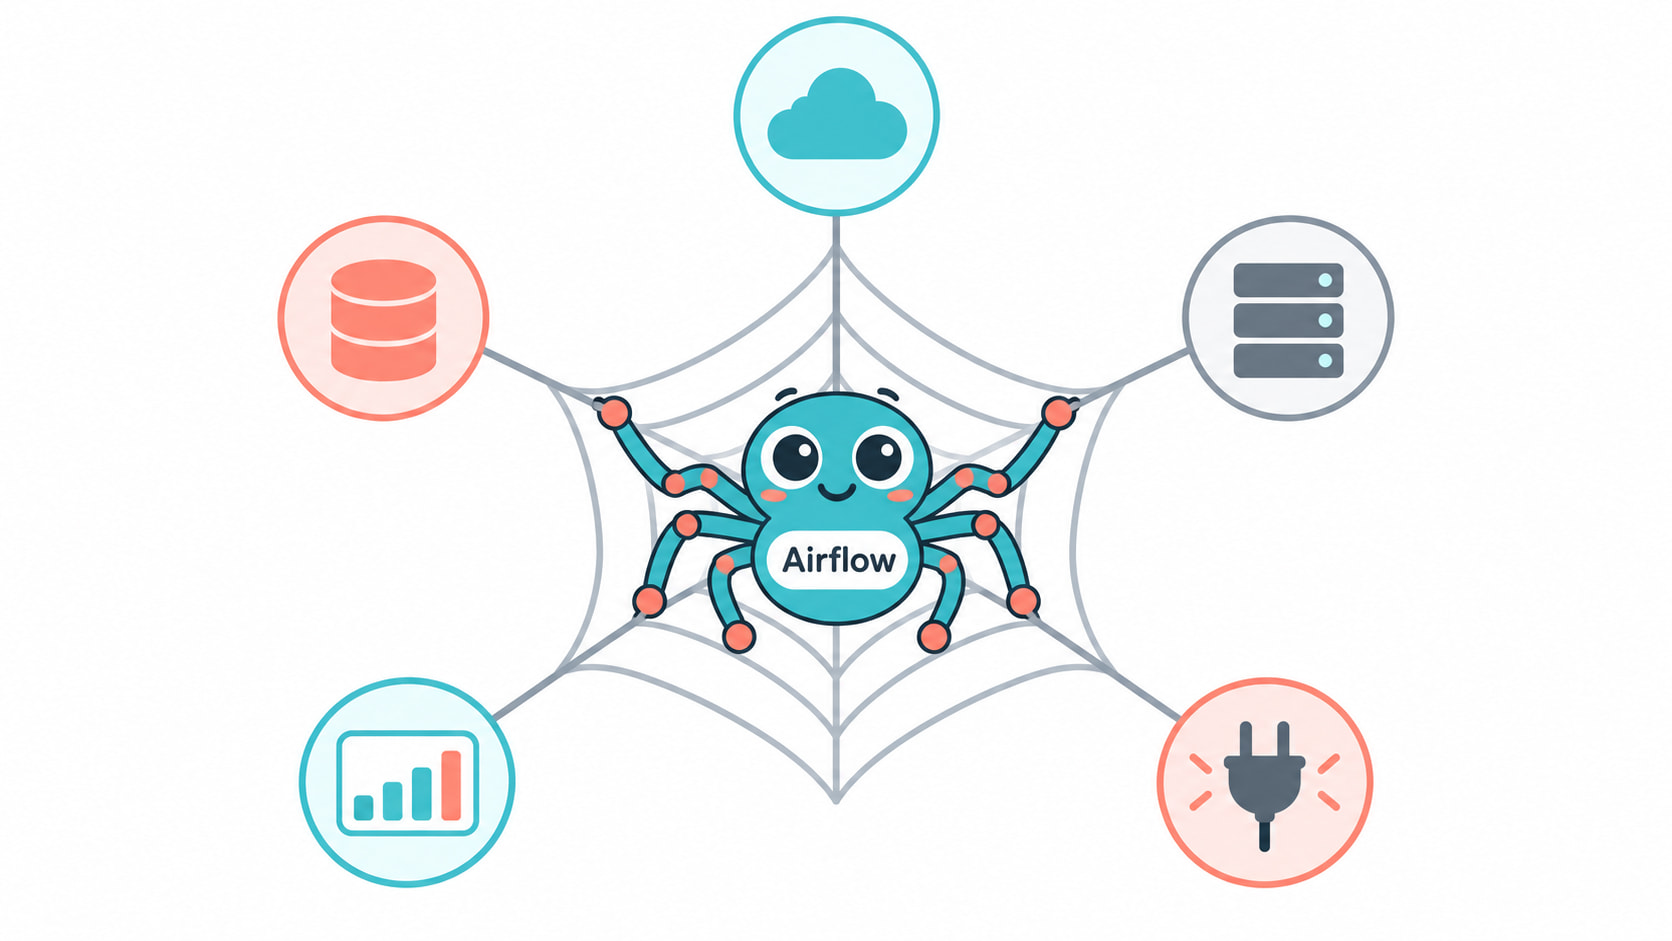
그래서 Airflow는 데이터를 직접 나르는 일꾼이라기보다, "무엇을, 어떤 순서로, 언제 할지"를 정하고 지시하는 관제탑에 가깝습니다. 태스크 안에서 파이썬으로 데이터를 직접 다룰 수도 있지만, 무거운 처리는 보통 데이터베이스나 Spark 같은 다른 시스템에 맡기고 Airflow는 그 일들이 정해진 순서와 시간에 맞게 돌아가도록 챙깁니다.
 1. 왜 스크립트가 아니라 ‘그래프(DAG)’인가?
 책 1.1절 · 그림 1.1~1.6
예제는 두 가지입니다. 실시간 날씨 대시보드 파이프라인과 우산 판매량 예측 머신러닝 파이프라인입니다.
우산 판매량 예측 모델을 학습시키려면 다음 단계가 필요합니다.
① 날씨 예보 가져오기 → 예보 데이터 정제
② 판매 데이터 가져오기 → 판매 데이터 정제
   (①과 ②는 서로 관련이 없으므로 동시에 실행할 수 있음)
③ ①·② 결과로 데이터 세트 결합 → 머신러닝 모델 훈련 → 모델 배포
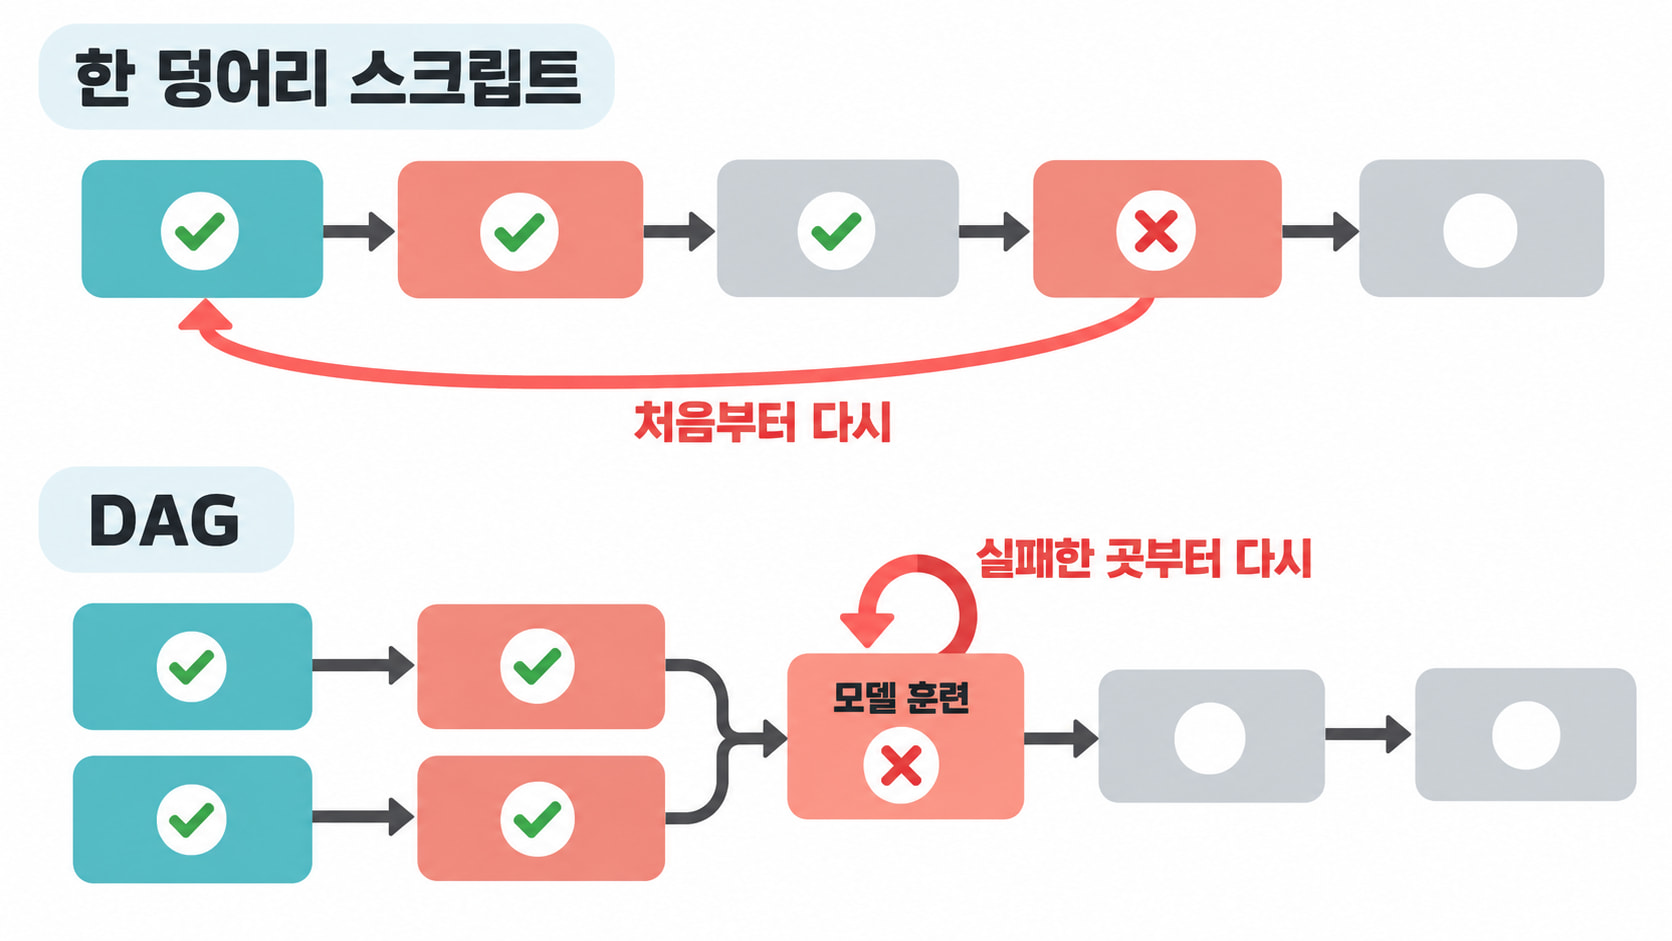
이 작업을 하나의 거대한 파이썬 스크립트(run_pipeline.py)로 순차 실행한다고 생각해 보겠습니다. 처음에는 단순해 보이지만 운영 환경에 들어가면 곧바로 세 가지 문제와 마주하게 됩니다.
- 불필요한 직렬 실행: 날씨 데이터를 가져오는 작업과 판매 데이터를 가져오는 작업은 서로 아무런 관련이 없는데도, 절차적 스크립트에서는 앞 작업이 끝날 때까지 뒤 작업이 기다려야 합니다.
- 실패 시 전체 재실행 비용: 날씨·판매 데이터 정제와 결합이 모두 끝나고
모델 훈련단계에서 일시적인 오류로 실패했다면, 모놀리식 스크립트는 이미 성공한 앞선 데이터 수집·정제 과정까지 처음부터 다시 돌려야 합니다. - 암묵적 의존성: 어떤 작업이 어떤 작업의 산출물에 의존하는지가 코드 내부 흐름에 묻혀 있어, 파이프라인이 커질수록 실행 순서를 추론하기 어려워집니다.
DAG, 도대체 뭘까?
Airflow를 비롯한 워크플로 매니저들은 이 문제를 풀기 위해 파이프라인을 그래프로 그립니다.
- 태스크는 노드(점)로 표시합니다.
- 태스크 사이의 의존성은 방향이 있는 화살표로 표시합니다. 태스크 A에서 B로 화살표가 있으면 "A가 끝나야 B를 시작할 수 있다"는 뜻입니다.
이렇게 화살표에 방향이 있는 그래프를 방향성 그래프(directed graph)라고 합니다. 여기에 "화살표를 따라가다 보면 제자리로 돌아오는 고리가 없어야 한다"는 조건이 하나 더 붙은 것이 DAG입니다.
| 글자 | 영어 | 뜻 |
|---|---|---|
| D | Directed | 방향성: 화살표에 방향이 있다 (무엇이 먼저인지 정해져 있다) |
| A | Acyclic | 비순환: 반복이나 순환(고리)을 허용하지 않는다 |
| G | Graph | 그래프: 점(태스크)과 화살표(의존성)로 이루어진 그림 |
정리하면 DAG는 방향이 있는 화살표로 태스크를 잇되, 반복이나 순환은 허용하지 않는 그래프입니다. 여기서 '반복이 없다’는 건 화살표를 따라가다 원래 태스크로 돌아오는 고리가 없다는 뜻입니다. 같은 DAG를 매일 다시 실행하는 것과는 다른 이야기입니다. 그리고 DAG에서 가장 중요한 건 태스크 하나하나보다 “무엇이 끝나야 무엇을 시작할 수 있는가”, 즉 의존성입니다.
앞의 우산 예제를 그래프로 그리면, 날씨 줄과 판매 줄이 따로 진행되다가 '데이터 세트 결합’에서 하나로 합쳐지는 모양이 됩니다(그림 1.6). 서로 기다릴 필요가 없는 태스크는 동시에 돌리고, 결과가 다 모이면 하나로 합치는 것입니다.
그럼 왜 반드시 '비순환’이어야 할까요? 문제는 순환 의존성입니다.
[비순환 그래프 (DAG)] — 명확한 실행 경로
태스크 1 ──→ 태스크 2 ──→ 태스크 3

[순환 그래프 (Cyclic)] — 상호 의존성으로 인한 교착 상태(Deadlock)
태스크 1 ──→ 태스크 2 ⇄ 태스크 3
(태스크 2는 3이 끝나야 실행되고, 태스크 3은 2가 끝나야 실행됨 → 영원히 실행 불가)
순환을 허용하는 순간, 워크플로 엔진은 "누구를 먼저 실행해야 하는가?"를 결정할 수 없는 논리적 교착 상태(Deadlock)에 빠집니다. 반대로 비순환(Acyclic) 속성을 강제하면, 파이프라인 실행은 놀라울 정도로 단순하고 결정론적인 루프 알고리즘이 됩니다.
[DAG 실행 알고리즘 루프]
1. 미완료(open) 태스크 중 업스트림(이전 태스크) 의존성이 모두 완료된 태스크를 찾는다.
2. 해당 태스크들을 실행 대기열(Queue)에 추가하고 병렬로 실행한다.
3. 완료된 태스크에 완료 표시를 하고, 새롭게 의존성이 풀린 다음 태스크를 찾는다.
4. 그래프의 모든 태스크가 완료될 때까지 1~3을 반복한다.
DAG로 파이프라인을 표현한다는 것은 단순히 그림을 예쁘게 그리는 것이 아니라, "병렬 실행 가능한 지점"과 "실패 시 다시 시작해야 할 경계"를 명확히 드러내는 것입니다.
그럼 '반복’하는 작업은 DAG로 못 만들까?
1.1.1절 끝에는 짧은 참고가 하나 있습니다. 머신러닝에서 모델을 반복 학습시키는 과정을 그린 순환 그래프와, 여기서 말하는 비순환 그래프는 다른 개념이라는 것입니다. 반복은 태스크 안에서 얼마든지 일어날 수 있습니다. DAG가 막는 건 태스크 사이의 화살표가 고리를 만드는 것뿐입니다.
[Airflow 2.0 이후 달라진 점] AI 에이전트 태스크
지금은 Airflow에서 LLM 에이전트를 태스크로 돌리는 AI 프로바이더(apache-airflow-providers-common-ai)가 나와 있습니다. 여기 있는AgentOperator(@task.agent)는 에이전트가 도구를 부르고, 결과를 보고, 다시 도구를 부르는 루프를 돕니다. 사람이 결과를 보고 수정을 요청하면 다시 만들어 내는 검토 루프도 붙일 수 있습니다. 공식 문서의 흐름도에도 ‘다시 돌아가는’ 화살표가 있어서 DAG 규칙과 부딪히는 것처럼 보입니다.
하지만 이 루프는 모두 태스크 하나 안에서 돕니다. DAG 그래프에는 이 태스크가 점 하나로 그려지고, 태스크 사이의 화살표에는 여전히 고리가 없습니다. 머신러닝 반복 학습과 같은 경우입니다.
그래서 cron으로 스크립트를 돌리는 것과 뭐가 다를까?
여기까지를 cron과 비교해 정리하면 이렇습니다.
| cron + 스크립트 하나 | Airflow (DAG) | |
|---|---|---|
| 실행 단위 | 스크립트 전체를 처음부터 끝까지 순서대로 | 작업을 여러 태스크로 나눠, 의존성에 맞춰 실행 |
| 서로 관계없는 작업 | 앞 작업이 끝날 때까지 기다림 | 동시에 실행 |
| 중간에 실패하면 | 처음부터 다시 | 실패한 태스크부터 다시 |
| 시간 개념 | "정해진 시간에 실행"만 앎 | 실행마다 "10월 15일 몫"처럼 담당 날짜를 붙이고, 날짜별 결과를 기록 (4절) |
| 과거 데이터 채우기 | 날짜를 바꿔 가며 직접 다시 실행하고, 어디까지 했는지도 직접 챙김 | 기간을 지정하면 날짜별 실행이 만들어지는 백필 (4절) |
| 상태 확인 | 로그 파일을 직접 열어 봄 | 웹 UI에서 태스크별 상태와 로그 확인 |
물론 cron으로도 스크립트를 여러 개로 나눌 수는 있습니다. 하지만 그러면 "무엇이 끝나야 무엇을 시작하는지"를 사람이 직접 챙겨야 합니다. Airflow는 그 의존성 관리를 DAG로 대신해 줍니다.
 2. 수많은 워크플로 매니저 중 왜 Airflow인가?
책 1.1.4절 · 표 1.1
의존성이 있는 태스크 그래프를 실행하려는 시도는 오래전부터 있었습니다. 표 1.1은 Oozie, Azkaban, Conductor, Luigi, Argo, Make, Metaflow, NiFi 등 여러 워크플로 관리 도구를 비교하는데, 아래는 그중 주요 도구만 추린 것입니다.
| 도구 | 시작 회사 | 워크플로 정의 방식 | 개발 언어 | 스케줄 관리 내장 | 백필(Backfill) | 웹 UI | 수평 확장 |
|---|---|---|---|---|---|---|---|
| Airflow | Airbnb | 파이썬 코드 | Python | O | O | O | O |
| Argo | Applatix | YAML | Go | 3rd party | - | O | O (K8s) |
| Luigi | Spotify | 파이썬 코드 | Python | X (Cron 필요) | O | O | O |
| Oozie | - | 정적 XML | Java | O | O | O | O (Hadoop) |
| Azkaban | YAML | Java | O | X | O | - | |
| Make | - | Custom DSL | C | X | X | X | X |
이 비교표에서 Airflow의 정체성을 결정짓는 세 가지 축이 보입니다.
- 정적 설정(XML/YAML)이 아닌 ‘파이썬 코드(Configuration as Code)’
Oozie처럼 정적 XML로 워크플로를 정의하면 읽기는 쉽지만 유연하지 않습니다. 반면 Airflow는 파이썬 스크립트로 DAG를 정의합니다. 파이썬 생태계의 수많은 라이브러리와 클라우드/DB SDK를 그대로 활용할 수 있고, 반복문이나 함수로 태스크를 유연하게 찍어낼 수 있습니다. 다만 단점도 있습니다. 코드로 정의한 워크플로는 작성자의 코딩 실력에 따라 읽고 테스트하기가 어려워질 수 있습니다. - 스케줄러와 웹 UI의 기본 내장
Make나 Luigi처럼 주기적으로 실행하려면Cron같은 추가 도구가 필요한 경우와 달리, Airflow는 자체 스케줄러와 모니터링 웹 UI를 코어 컴포넌트로 품고 있습니다. - 시간 슬롯 기반의 증분 처리와 백필(Backfill)
단순히 "지금 실행해라"가 아니라, 실행마다 "어느 날짜(구간)의 데이터를 처리하는 실행인지"를 붙여서 관리합니다. 4절에서 자세히 봅니다.
 3. Airflow를 움직이는 핵심 아키텍처
책 1.2.1~1.2.3절 · 그림 1.7~1.13
Airflow는 파이프라인을 스케줄링하고 실행하는 일을 크게 세 구성 요소(스케줄러·워커·웹 서버)와, 이들이 함께 쓰는 메타스토어로 나눕니다.
| 순서 | 누가 | 무엇을 |
|---|---|---|
| 1 | 사용자 | 파이썬으로 DAG 파일을 작성해 DAG 폴더에 둔다 |
| 2 | 스케줄러 | DAG 파일을 파싱해 태스크·의존성·스케줄 주기를 읽고, 직렬화한 DAG를 메타스토어에 저장한다 |
| 3 | 스케줄러 | 스케줄 주기가 지났고 업스트림 태스크가 모두 끝난 태스크를 대기열(Queue)에 넣는다 |
| 4 | 워커 | 대기열에서 태스크를 가져와 실행하고, 결과를 메타스토어에 저장한다 |
| 5 | 웹 서버 | 메타스토어를 읽어 DAG 구조와 실행 결과를 보여 주고, 사용자는 여기서 모니터링한다 |
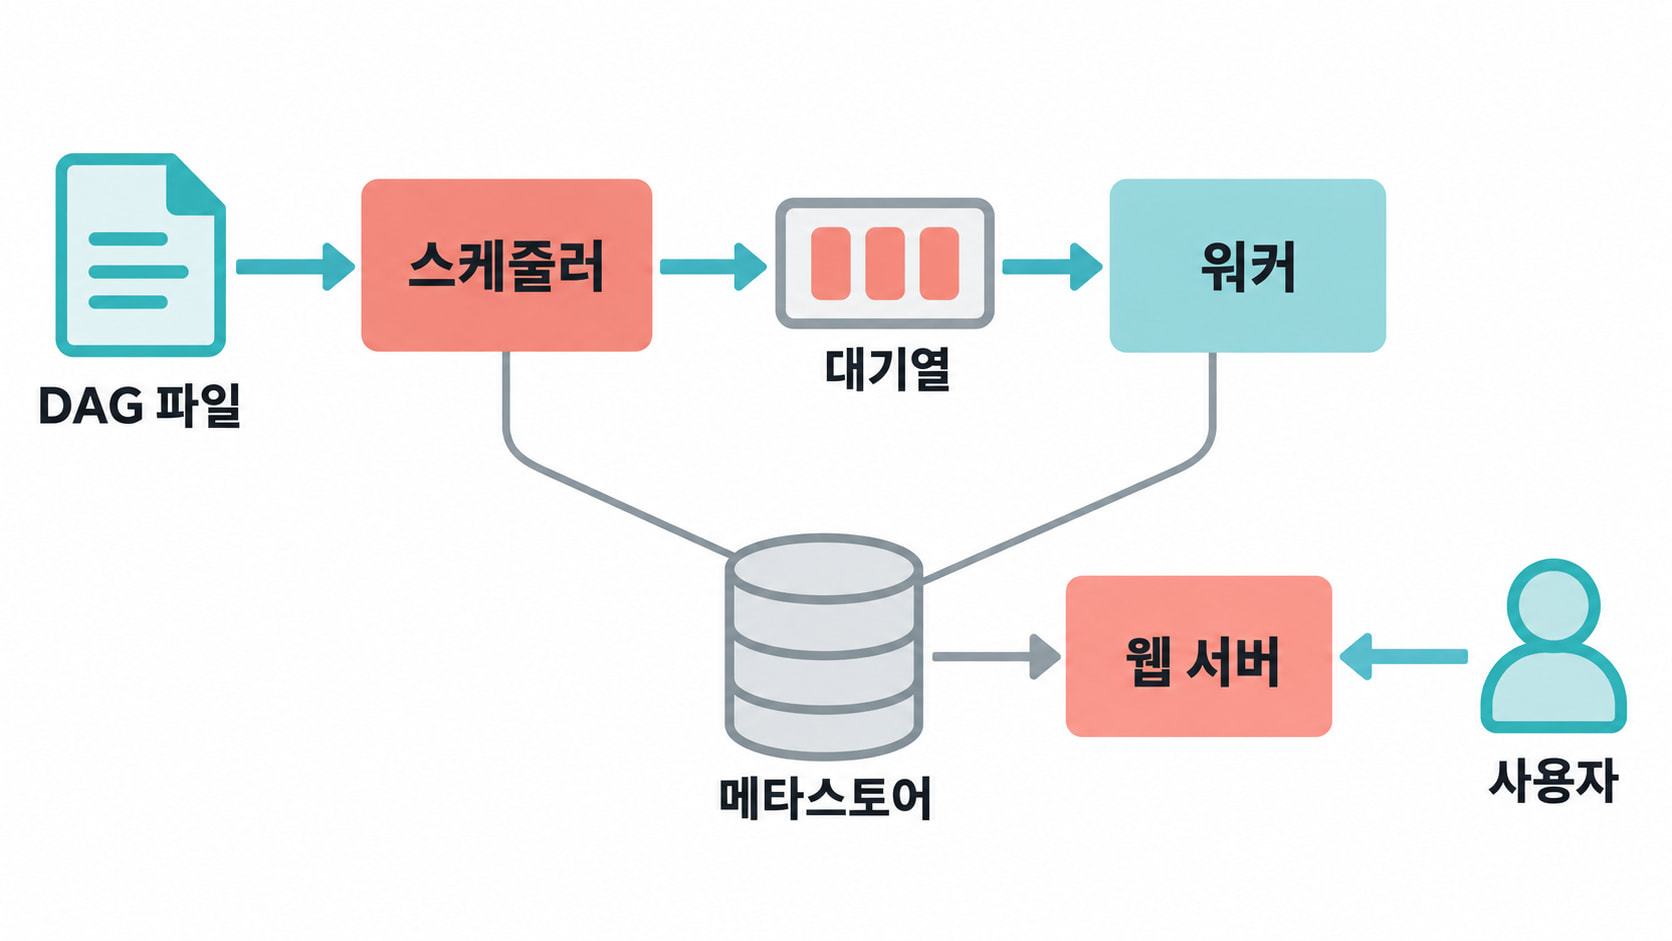
스케줄러는 이 과정을 계속 반복합니다. 한 바퀴 확인하고 잠깐 기다렸다가 다시 확인하는, 일종의 폴링(polling) 방식입니다(그림 1.9의 “X초만큼 대기”). 앞에서 본 DAG 실행 알고리즘이 그대로 스케줄러의 동작 방식이 되는 셈입니다.
- 스케줄러: “무엇을 언제 실행할지” 결정만 합니다. DAG 파일을 파싱해 태스크·의존성·스케줄 주기를 파악하고(Airflow 3에서는 이 파싱을 DAG 프로세서가 따로 맡습니다), 실행할 때가 됐고 앞 태스크가 모두 끝난 태스크를 대기열에 넣습니다. 태스크를 직접 실행하지는 않습니다.
- 워커: 실제로 "실행"하는 쪽입니다. 대기열에서 태스크를 꺼내 실행하고, 결과(성공/실패, 로그)를 남깁니다. 워커가 동시에 실행할 수 있는 자리(슬롯)는 정해져 있어서, 자리가 다 차면 실행할 준비가 된 태스크도 빈자리가 날 때까지 기다립니다.
- 메타스토어: Airflow의 기록장(데이터베이스)입니다. DAG 구조, 실행 기록, 태스크 상태처럼 Airflow가 작업을 관리하는 데 필요한 정보가 저장됩니다. 파이프라인이 처리하는 데이터 자체가 아니라, "어떤 작업을 언제 어떻게 처리했는지"에 대한 기록입니다. 로컬 실습에서는 내 컴퓨터의 SQLite 파일로도 돌아가지만, 운영 환경에서는 PostgreSQL 같은 별도 데이터베이스를 씁니다.
- 웹 서버: 눈으로 확인하는 창입니다. 메타스토어를 읽어 DAG 구조(Graph View)와 날짜별 실행 이력(책 시절의 Tree View, 지금의 Grid View), 로그를 보여 줍니다.
파싱(parsing)과 실행은 다릅니다
- 파싱: DAG 파일을 읽어 구조를 파악하는 과정입니다. 어떤 DAG가 있는지, 그 안에 어떤 태스크가 있는지, 태스크끼리 어떻게 연결되는지(의존성)를 알아냅니다. 이때 태스크 안의 실제 데이터 처리는 일어나지 않습니다.
- 실행: 스케줄러가 대기열에 넣은 태스크를 워커가 실제로 돌리는 과정입니다. 데이터를 가져오고 정제하는 일은 이때 일어납니다.
주의할 점이 하나 있습니다. 파싱할 때 Airflow는 DAG 파일을 일반 파이썬 파일처럼 위에서부터 끝까지 실행합니다. 실행이 미뤄지는 건 함수 본문뿐입니다. 태스크로 등록한 함수의 본문은 나중에 태스크가 실행될 때 호출되지만, 함수 밖에 적힌 코드는 파싱할 때마다 실제로 실행됩니다. 게다가 파싱은 기본 30초(최소 간격)마다 반복됩니다.
import pendulum
import requests

from airflow.sdk import DAG

# ❌ 파일 최상위: 파싱할 때마다(기본 30초 간격) API를 호출합니다
cities = requests.get("https://api.example.com/cities").json()

# 파싱 때 실행: DAG를 하나 만듭니다
with DAG(
    dag_id="parsing_bad",
    start_date=pendulum.datetime(2026, 10, 1, tz="Asia/Seoul"),
    schedule="@daily",
):
    # ❌ 들여쓰기로 with DAG 블록 안에 있지만, 함수 밖이라 파싱할 때 실행됩니다
    regions = requests.get("https://api.example.com/regions").json()
with DAG 블록은 "이 안에서 만든 태스크를 이 DAG에 넣는다"는 표시일 뿐, 안의 코드를 나중으로 미뤄 주지 않습니다. 그래서 블록 안에 들어간 regions 줄도 파일 맨 위의 cities 줄처럼 파싱할 때마다 API를 부릅니다.
API 호출을 태스크 함수 안으로 옮기면 이렇게 됩니다.
import pendulum

from airflow.sdk import DAG, task

# 파싱 때 실행: DAG를 하나 만듭니다
with DAG(
    dag_id="parsing_good",
    start_date=pendulum.datetime(2026, 10, 1, tz="Asia/Seoul"),
    schedule="@daily",
):

    # 파싱 때는 "이런 함수가 있다"고 정의만 합니다
    @task
    def fetch_cities():
        # ✅ 함수 안: 파싱 때는 건너뛰고, 태스크가 실행될 때 돕니다
        import requests  # 무거운 라이브러리도 여기서 불러오면 파싱이 가벼워집니다

        return requests.get("https://api.example.com/cities").json()

    # 파싱 때 실행되지만, @task가 붙은 함수라 태스크 등록만 합니다
    fetch_cities()
맨 아래 fetch_cities()는 함수 밖이라 파싱 때 실행되지만, @task가 붙은 함수는 불러도 본문을 돌리지 않고 DAG에 태스크를 하나 등록하기만 합니다. 본문의 API 호출은 나중에 워커가 이 태스크를 실행할 때 일어납니다. 반대로 @task가 없는 일반 함수를 이 자리에서 부르면, 그 본문이 파싱할 때 그대로 실행됩니다.
라이브러리 import도 함수 밖에 있으면 파싱할 때마다 실행되는 코드입니다. 그래서 두 번째 예는 requests를 파일 맨 위가 아니라 태스크 함수 안에서 불러왔습니다. pandas나 머신러닝 라이브러리처럼 불러오는 데 시간이 꽤 걸리는 라이브러리는, 그 라이브러리를 쓰는 태스크 함수 안에서 불러오면 파싱이 가벼워집니다. pendulum이나 airflow.sdk처럼 DAG를 정의하는 데 필요한 가벼운 import는 맨 위에 둬도 됩니다. Airflow 공식 문서의 모범 사례(Best Practices)도 이 방법을 권합니다.
실제로 두 파일을 Airflow 3.3.2에서 불러와 보면, 첫 번째 파일은 파싱하는 순간 API를 호출하다가 오류가 나서 DAG로 등록되지 않습니다(예시 주소라 연결이 안 되기 때문입니다). 두 번째 파일은 API를 한 번도 부르지 않고 태스크 1개짜리 DAG로 문제없이 불러와집니다.
정리하면, DB 조회나 API 호출, 무거운 계산과 무거운 라이브러리 import는 파일에 바로 적지 말고 태스크 함수 안에 넣어야 합니다. 책도 뒤의 11.1.4절에서 같은 이야기를 합니다. DAG 파일을 읽을 때마다 오래 걸리는 계산이 돌면 그만큼 파싱이 늦어지니, 계산은 태스크 안으로 옮기라는 것입니다.
실패하면 어떻게 되나 (1.2.3)
Airflow는 실패한 태스크를 재시도할 수 있습니다(재시도 간격도 설정 가능). 다만 기본 재시도 횟수는 0이라, retries를 지정해야 재시도합니다. 재시도까지 실패하면 실패를 기록하고, 알림을 설정해 두었다면 사용자에게 알립니다. 사용자는 웹 UI에서 실패한 태스크의 로그를 확인하고, 그 태스크와 뒤따르는 태스크의 상태만 초기화(Clear)해서 다시 실행할 수 있습니다. Clear는 이력을 지우는 게 아니라 상태를 되돌리는 것이라, 이전 시도 기록은 그대로 남습니다. 1절에서 본 "실패한 부분만 다시 실행한다"는 그래프의 장점이 실제 화면 기능으로 이어지는 지점입니다.
단, 재시도나 다시 실행이 안전하려면 태스크가 멱등(idempotent)해야 합니다. 같은 태스크를 몇 번 실행해도 결과가 같아야 한다는 뜻입니다. 예를 들어 같은 날짜 데이터를 두 번 넣어도 중복이 생기지 않아야 합니다. Airflow가 멱등성을 대신 지켜 주지는 않으니, 태스크를 그렇게 설계해야 합니다. 멱등성은 3장(3.6 태스크 디자인을 위한 모범 사례)에서 자세히 다룹니다.
책의 화면과 구조는 Airflow 2.0 베타 기준입니다. 그 뒤로 이렇게 바뀌었습니다.
- Triggerer (2.2~): 외부 작업을 기다리는 태스크(Deferrable Operator)가 기다리는 동안 워커 슬롯을 붙잡지 않도록, 대기만 따로 맡는 컴포넌트가 생겼습니다.
- Grid View (2.3~): 책에 나오는 Tree View는 Grid View로 바뀌었습니다.
- Airflow 3: 구조가 크게 바뀌었습니다. 웹 서버 자리를 API 서버가 대신하고, 워커는 더 이상 메타스토어(DB)에 직접 붙지 않고 API 서버를 거쳐 상태를 주고받습니다. DAG 파일 파싱도 스케줄러에서 떨어져 나와 DAG 프로세서라는 별도 프로세스가 맡습니다.
그래서 책의 그림처럼 “모든 컴포넌트가 DB 하나를 직접 바라보는” 구조는 Airflow 3에서는 더 이상 그대로가 아닙니다. 다만 "스케줄러가 판단하고, 대기열을 거쳐, 워커가 실행한다"는 역할 분담은 지금도 같습니다.
 4. 단순 cron을 넘어서는 이유: 점진적 로딩(Incremental Loading)과 백필(Backfill)
책 1.2.4절
1장에서 가장 밑줄 치고 봐야 할 대목입니다. 그런데 처음 읽으면 잘 와닿지 않습니다. 책도 이 부분에 "지금 이해되지 않아도 걱정하지 말라, 뒤에서 더 자세히 설명한다"는 각주를 달아 두었습니다. 저도 "cron에 날짜만 넘기면 되는 거 아닌가?"가 가장 먼저 든 의문이었습니다. 예시로 하나씩 풀어 보겠습니다.
Airflow는 실행마다 '담당 날짜’를 붙입니다
cron은 "매일 0시에 이 명령을 실행해라"만 압니다. 실행하고 나면 그걸로 끝이고, 어제 실행이 성공했는지는 cron이 모릅니다.
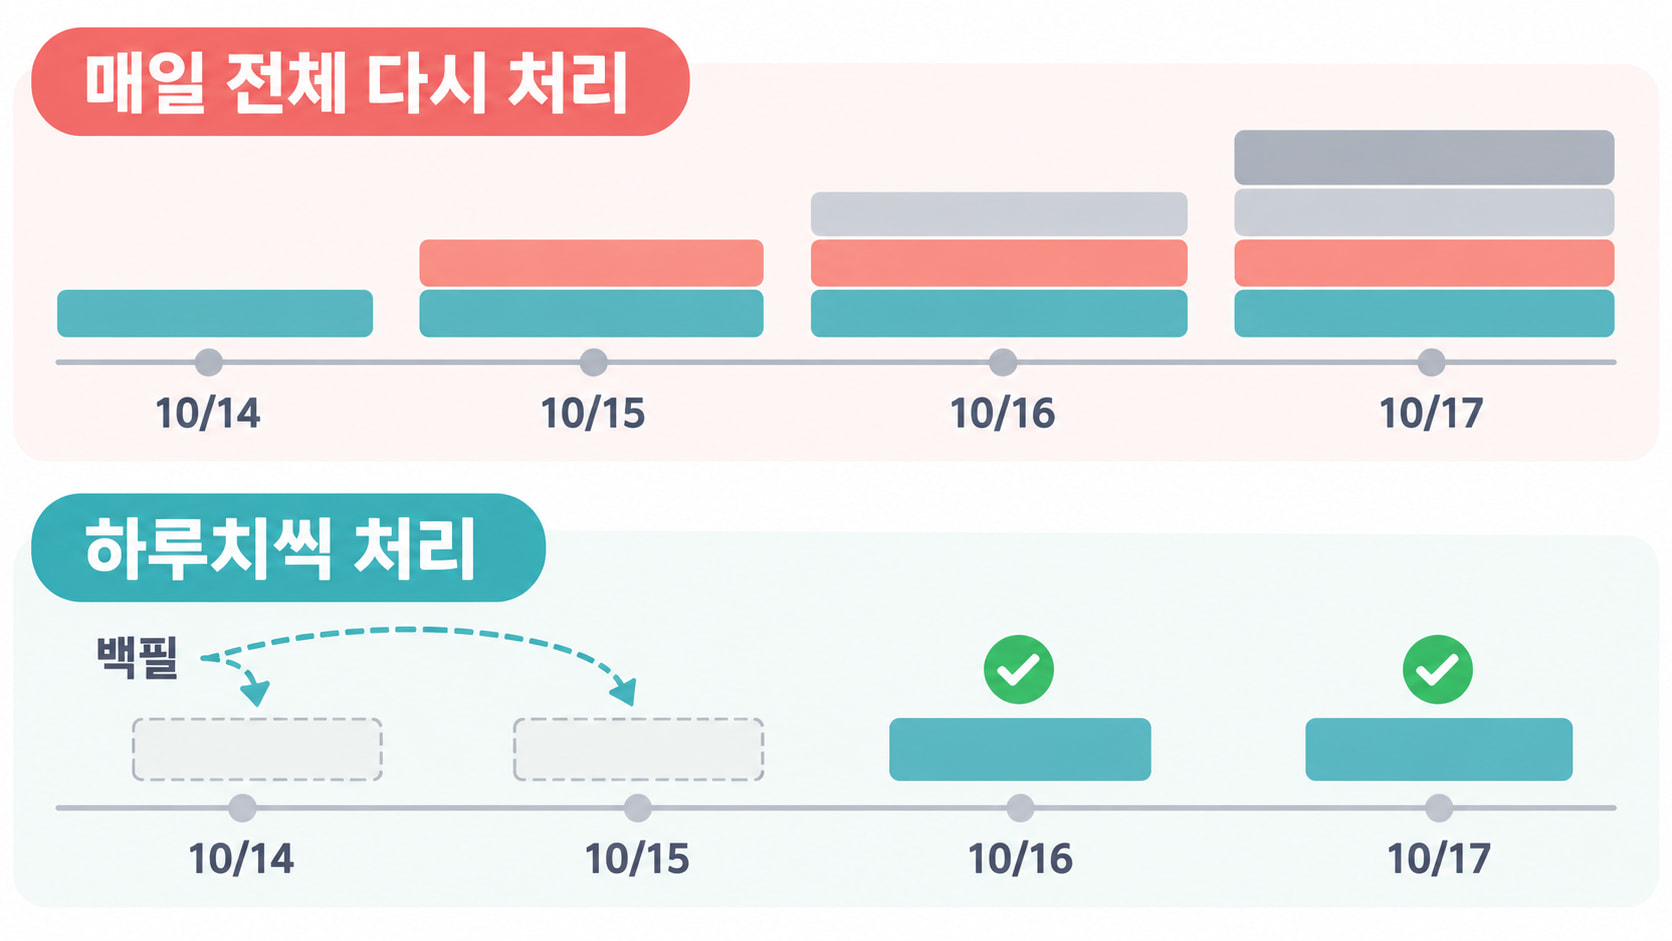
Airflow는 스케줄을 날짜 칸으로 나눕니다. 이 칸이 책에서 말하는 시간 슬롯입니다. 그리고 실행 하나하나에 “너는 10월 15일 몫” 하고 담당 날짜를 붙이고, 그 칸이 성공했는지 실패했는지를 메타스토어에 남깁니다. 1.2.4절의 표현으로는 Airflow가 마지막 실행 시점과 다음 스케줄 주기를 상세하게 알려 준다는 것입니다.
날짜 칸     10/14   10/15   10/16   10/17
DAG 실행     ✅      ✅      ❌      ✅
                             └ 실패한 10/16 칸만 다시 실행하면 된다
담당 날짜는 '언제 실행했느냐’가 아니라 '어느 날 몫을 처리하느냐’입니다. 10월 15일 몫 실행을 10월 18일에 다시 돌려도, 처리 대상은 여전히 10월 15일 데이터입니다.
그럼 델타는 Airflow가 찾아 줄까?
아닙니다. Airflow는 데이터를 들여다보지 않습니다. 실행마다 담당 날짜를 넘겨 주기만 하고, 그 날짜로 그날 데이터만 가져오는 건 우리가 짠 쿼리가 합니다.
-- 10/15 몫 실행이라면, Airflow가 넘겨 준 날짜가 들어갑니다
SELECT * FROM sales WHERE sale_date = '2026-10-15';
그렇다고 데이터베이스가 매번 전체를 읽는 것도 아닙니다. 날짜 컬럼에 인덱스(원하는 날짜의 데이터가 어디 있는지 찾아 주는 색인)를 만들어 두거나, 테이블을 날짜별 파티션(날짜 단위로 나눠 저장한 구획)으로 나눠 두면, 데이터베이스는 전체를 읽지 않고 그날 데이터가 있는 곳만 찾아 읽을 수 있습니다. 원천이 API라면, 날짜 검색을 지원하는 경우 ?date=2026-10-15처럼 날짜를 조건으로 넘기면 됩니다. 이렇게 해서 1년 치를 매일 다시 처리하지 않고 하루치씩만 처리합니다.
이 방식은 판매 기록처럼 데이터가 날짜별로 새로 쌓이는 경우에 잘 맞습니다. 이미 지난 날짜의 데이터가 나중에 수정되는 경우까지 잡으려면, 수정 시각 같은 별도 기준이 필요합니다. (실행마다 날짜를 어떻게 넘겨받는지는 3~4장에서 다룹니다.)
매일 1년 치를 다시 처리하는 방식 (비효율)
[Day 1 ~ Day 365 전체] ──→ 매일 막대한 시간과 비용

하루치씩 처리하는 방식 (점진적 로딩)
[10/15 몫 실행] ──→ 10월 15일 데이터만
[10/16 몫 실행] ──→ 10월 16일 데이터만
[10/17 몫 실행] ──→ 10월 17일 데이터만
잠깐, cron에 날짜만 넘기면 되는 거 아닌가?
맞습니다. python run_pipeline.py --date 2026-10-15처럼 날짜를 받는 스크립트를 만들면 cron으로도 하루치씩 처리할 수 있습니다. 과거 날짜를 반복문으로 돌리면 백필도 되고, 멱등하게 짜 두면 다시 돌려도 안전합니다. 차이는 할 수 있느냐가 아니라, 그 주변 일을 누가 챙기느냐입니다.
| 해야 할 일 | cron + 날짜를 받는 스크립트 | Airflow |
|---|---|---|
| 이번 실행이 맡을 날짜 | 스크립트가 직접 계산 (예: 어제 날짜) | 실행마다 Airflow가 넘겨 줌 |
| 날짜별 성공·실패 | 로그를 뒤지거나 직접 기록 | 메타스토어에 남고, 웹 UI 격자로 한눈에 보임 |
| 서버가 꺼져 있던 날 | 그날 실행은 그냥 빠짐 | 마지막 실행 기록이 남아 있어서, 빠진 날짜를 자동(catchup)이나 백필로 채움 |
| 1년 치 백필 | 날짜 반복문을 직접 작성. 중간에 실패하면 어디까지 했는지 직접 추적 | 기간만 지정하면 날짜별 실행이 만들어짐. 동시 실행 개수 제한, 실패한 날짜만 다시 실행 |
| 로직을 고친 뒤 재처리 | 날짜 범위를 넣어 다시 실행 | 그 기간을 Clear 해서 다시 실행 |
“그럼 1년 치를 한 번에 처리하는 큰 실행 하나로 돌리면 되지 않나?” 하는 생각도 들 수 있습니다. 가능은 합니다. 다만 어디까지 처리했는지 기록하지 않는 스크립트라면, 중간에 실패했을 때 1년 치를 처음부터 다시 돌려야 하고 한 번에 처리하는 양도 커서 무겁습니다. 이어서 처리하는 기능을 스크립트에 직접 만들 수도 있지만, 날짜별로 나눠 두면 Airflow가 날짜마다 상태를 기록하니 실패한 날짜만 다시 돌리면 됩니다. 1절에서 작업을 태스크로 나눈 것과 같은 이유입니다.
태스크로 나누는 게 '작업’을 쪼개는 것이라면, 시간 슬롯은 '시간’을 쪼개는 것입니다. 둘 다 "실패한 부분만 다시"를 가능하게 합니다.
이렇게 각 DAG 실행이 자기 날짜 몫만 처리하도록 만들어 두면, 두 가지 능력이 자연스럽게 따라옵니다.
- 백필 (Backfill): 오늘 새로 만든 파이프라인을 과거 1년 치 시간 슬롯에 대해 소급 실행해서, 과거 데이터를 채워 넣을 수 있습니다.
- 재처리 (Re-processing): 비즈니스 로직이나 버그를 수정한 뒤, 다시 처리할 기간의 태스크를 초기화(Clear)해 재실행하면 그 기간의 데이터를 수정된 로직으로 다시 만들 수 있습니다. 대상 기간을 전체로 잡으면 데이터 세트 전체도 이렇게 재구성할 수 있습니다.
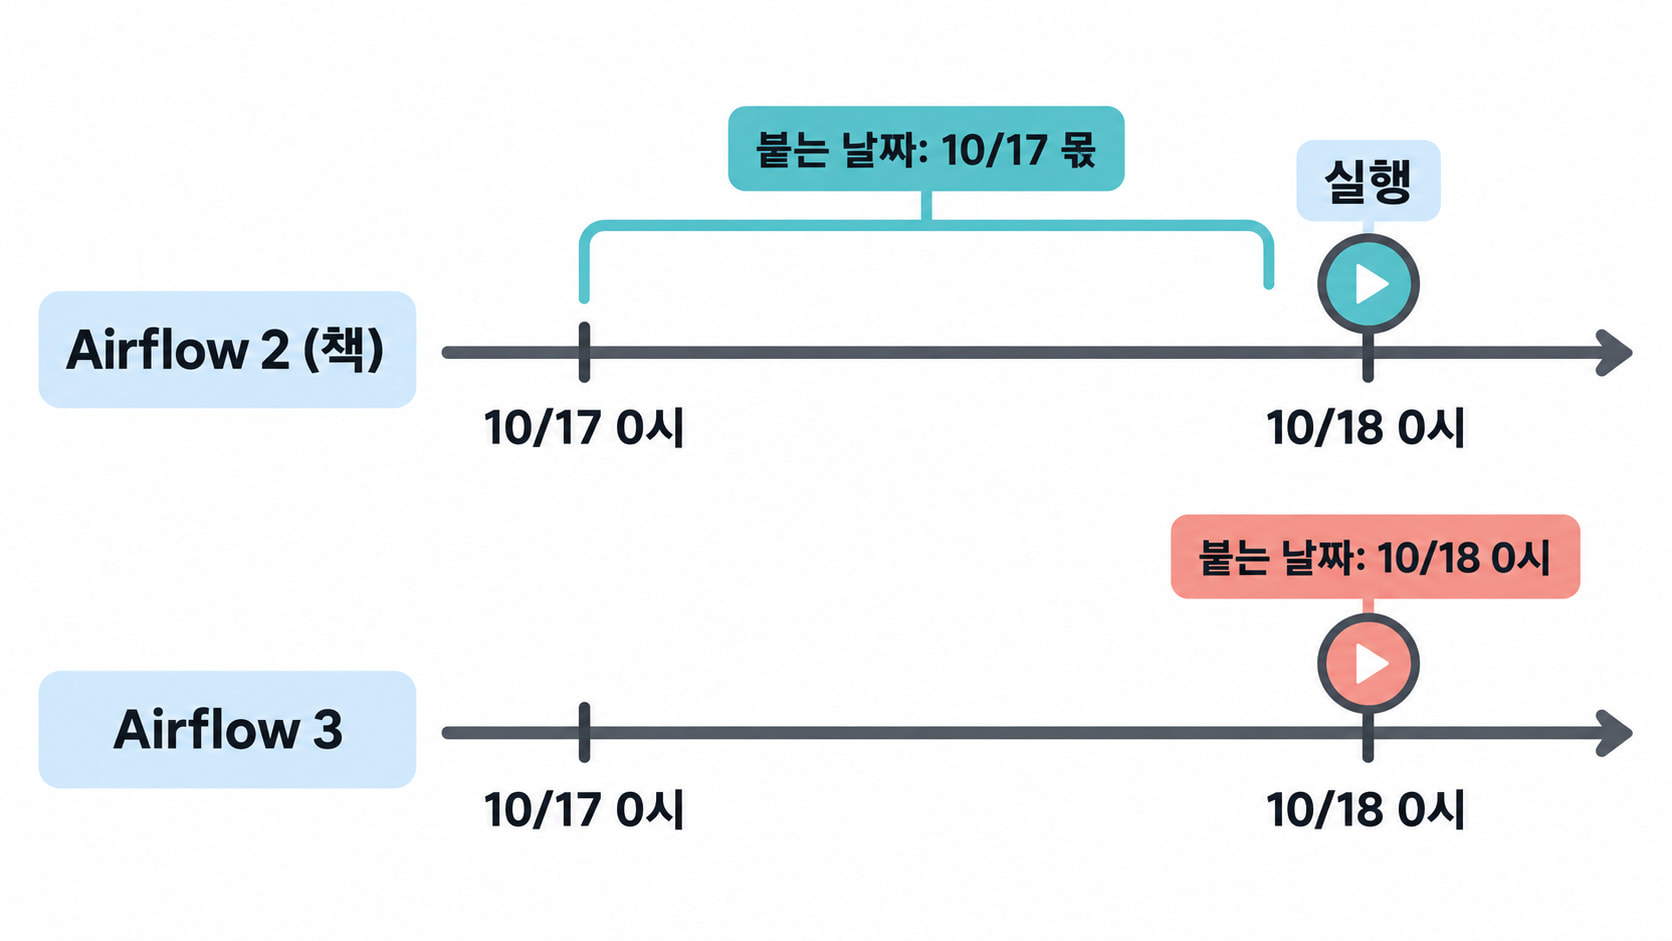
@daily실행에 붙는 날짜가 달라졌습니다. 매일 자정에 한 번 도는 건 그대로이고, 그 실행에 어떤 날짜를 붙여 코드에 넘겨 주느냐가 바뀌었습니다. 코드는 이 날짜를 보고 어느 날 데이터를 가져올지 정하고, 웹 UI에 보이는 실행 날짜도 이 값입니다. "매일 자정에 어제 판매량을 집계하는 DAG"로 보면, 10월 18일 0시에 도는 실행이 집계할 건 막 끝난 10월 17일 판매입니다.
10/18 0시에 도는 실행 Airflow 2 (책) Airflow 3 실제로 도는 시각 10/18 0시 10/18 0시 (같음) 붙는 날짜 (코드가 받는 날짜) 10/17 10/18 0시 어제(10/17) 판매를 집계하려면 받은 날짜를 그대로 받은 날짜에서 하루를 빼서
Airflow 2는 처리할 데이터의 날짜, 즉 이 실행이 어느 날 몫(10/17 0시~10/18 0시)을 처리하는지를 붙였습니다. Airflow 3은 이 실행이 돌기로 예정된 시각을 붙입니다. 그래서 Airflow 3에서 받은 날짜를 그대로 쓰면, 이제 막 시작해서 데이터가 거의 없는 10/18을 집계하게 됩니다. 붙는 날짜는 실제로 돈 시각이 아니라서, 실행이 늦게 시작되거나 나중에 다시 돌려도 바뀌지 않습니다.
- 책과 같은 구간 방식을 쓰고 싶다면
schedule에CronDataIntervalTimetable을 넘기거나, 설정에서[scheduler] create_cron_data_intervals = True로 켭니다. 기본값에서는 데이터 구간의 시작(data_interval_start)과 끝(data_interval_end)도 둘 다 붙은 시각과 같습니다.- 자정은 DAG의 시간대 기준입니다.
start_date에tz="Asia/Seoul"처럼 시간대를 주지 않으면 기본값인 UTC 자정, 즉 한국 시간 오전 9시에 돕니다.catchup기본값이False로 바뀌었습니다. DAG를 켜자마자 과거 구간 실행이 한꺼번에 몰려드는 일은 기본적으로 없고, 과거 구간은 백필로 명시적으로 채우는 쪽이 기본이 됐습니다.- 백필은 스케줄러가 직접 관리하고, CLI뿐 아니라 웹 UI에서도 실행할 수 있습니다.
- 재처리할 때 어떤 코드로 도는지 확인하세요. 기본 DAG 폴더(로컬 번들)는 항상 최신 코드로 다시 돌지만, Git 번들처럼 버전을 관리하는 DAG 번들을 쓰면 Clear 했을 때 원래 실행 당시의 코드로 다시 돕니다. 고친 로직으로 재처리하려면 “최신 버전으로 재실행” 옵션을 골라야 합니다.
헷갈리기 쉬운 말 정리
| 말 | 뜻 |
|---|---|
| 워커 슬롯 | 워커가 동시에 실행할 수 있는 자리. 다 차면 실행할 준비가 된 태스크도 기다립니다 (3절) |
| 시간 슬롯 | 책의 방식에서 한 번의 실행이 맡는 날짜·시간 구간. 예: 10월 15일 하루치. Airflow 3 기본 @daily에서는 이 구간이 자동으로 주어지지 않습니다 (4절 노트) |
| 파싱 | DAG 파일을 읽어 태스크와 의존성 구조를 파악하는 것 (3절) |
| 실행 | 워커가 태스크를 실제로 돌려 데이터를 처리하는 것 (3절) |
| 정제 | 결측치·중복·잘못된 값을 고쳐 데이터를 쓸 수 있게 다듬는 일. 파이프라인 안의 한 단계입니다 (예: 예보 데이터 정제) |
| 재구성 | 원천 데이터에서 결과 데이터를 다시 만들어 내는 일. 로직을 고친 뒤 과거 구간을 다시 실행하는 경우입니다 |
 5. 언제 Airflow를 쓰고, 언제 쓰지 말아야 할까?
책 1.3절
어떤 도구든 만능은 아닙니다. 1.3절은 Airflow를 고를 이유와 함께 Airflow가 맞지 않는 경우도 짚어 줍니다.
 Airflow를 선택하는 이유 (1.3.1)
- 파이썬 코드로 파이프라인을 만듭니다. 파이썬으로 할 수 있는 거의 모든 방법을 써서 복잡한 맞춤형 파이프라인을 만들 수 있습니다.
- 확장하기 쉽습니다. 데이터베이스, 클라우드 서비스 등 다양한 시스템과 연결할 수 있는 애드온이 커뮤니티에 아주 많습니다.
- 다양한 스케줄링 기법을 지원합니다. 정기적으로 실행하면서 증분(점진적) 처리를 할 수 있어, 매번 전체 데이터를 처음부터 다시 처리할 필요가 없습니다.
- 백필로 과거 데이터를 쉽게 다시 처리합니다. 코드를 고친 뒤 과거 데이터를 다시 만들어야 할 때 특히 유용합니다.
- 웹 UI가 좋습니다. 실행 결과를 모니터링하고, 오류를 디버깅하기 편합니다.
- 오픈소스입니다. 특정 업체에 묶이지 않고, 설치·운영 부담을 덜고 싶다면 여러 회사가 제공하는 관리형(managed) Airflow를 쓸 수도 있습니다.
 Airflow가 적합하지 않은 경우 (1.3.2)
- 스트리밍(실시간 데이터 처리) 워크플로. Airflow는 반복적이거나 배치로 도는 작업에 초점이 맞춰져 있습니다.
- 태스크가 수시로 추가·삭제되는 동적인 파이프라인. 책이 나올 당시 웹 UI는 DAG의 가장 최근 정의만 보여 줬습니다. 그래서 1.3.2절은 Airflow가 "실행되는 동안 구조가 변경되지 않는 파이프라인에 좀 더 적합하다"고 정리합니다. 태스크 구성이 자주 바뀌면 지난 실행 기록을 제대로 보기 어렵다는 뜻입니다.
- 파이썬 경험이 거의 없는 팀. 이런 팀은 Azure Data Factory처럼 화면에서 워크플로를 만드는 도구가 더 나을 수 있습니다.
- 규모가 커지면 DAG 코드가 복잡해집니다. 그래서 처음부터 엄격하게 관리해야 합니다.
- 데이터 계보나 데이터 버전 관리 같은 기능은 기본 제공하지 않습니다. 데이터 계보(lineage)는 데이터가 어디서 와서 어떤 변환을 거쳤는지 추적하는 것이고, 데이터 버전 관리는 데이터의 이전 상태를 보존하는 것입니다. 필요하면 이런 기능을 가진 도구를 직접 연동해야 합니다.
왜 실시간에는 맞지 않을까?
Airflow는 “정해진 때가 되면 스케줄러가 태스크를 대기열에 넣고, 워커가 꺼내서 실행하는” 구조입니다. 그래서 태스크 하나가 시작되기까지 시간이 걸리고, 데이터가 한 건 들어올 때마다 바로 처리해야 하는 실시간(스트리밍) 처리에는 맞지 않습니다. 실시간 처리는 Kafka나 Spark Streaming 같은 도구에 맡기고, Airflow는 그 주변의 배치 작업(하루치 집계, 빠진 데이터 다시 채우기 등)을 조율하는 데 쓰는 게 일반적입니다.
그리고 파이썬의 자유도는 양날의 검입니다. 무엇이든 짤 수 있다는 건, 처음부터 코드 규칙을 세워 두지 않으면 규모가 커졌을 때 손대기 힘든 스파게티 DAG가 된다는 뜻이기도 합니다.
- 1.3.2에서 지적한 "웹 UI는 DAG의 가장 최근 정의만 보여 준다"는 한계는 Airflow 3의 DAG 버전 관리로 상당 부분 풀렸습니다. 실행 당시의 DAG 구조를 그대로 확인할 수 있습니다.
- 입력 파일 수처럼 실행 중에 정해지는 개수만큼 같은 작업을 늘리는 패턴은 2.3부터 Dynamic Task Mapping으로 지원합니다. 다만 이는 같은 작업의 개수를 늘리는 기능이라, DAG의 구조 자체를 실행마다 바꾸는 것과는 구분해서 봐야 합니다.
- "데이터 계보(Lineage)는 직접 통합해야 한다"는 부분도, 지금은 OpenLineage 연동(provider)으로 붙일 수 있습니다.
- 다만 이벤트 기반 스케줄링이 생겼다고 해서 Airflow가 스트리밍 엔진이 된 것은 아닙니다. 배치 오케스트레이터라는 정체성은 그대로입니다.
 6. 맛보기 실습: 책 1장 예제, Airflow 3에서 그대로 돌아갈까?
저자 저장소 chapter01 · 그림 1.12
책의 예제 코드는 저자 저장소(BasPH/data-pipelines-with-apache-airflow)에 있습니다. 1장 예제는 앞에서 본 우산 판매 예측 파이프라인(그림 1.6, 1.12)을 빈 태스크로만 표현한 chapter01/dags/01_umbrella.py 파일 하나입니다. 핵심 부분은 이렇습니다.
# 책 원본 (Airflow 2.0 기준) 중 일부
import airflow.utils.dates
from airflow import DAG
from airflow.operators.dummy import DummyOperator

dag = DAG(
    dag_id="01_umbrella",
    start_date=airflow.utils.dates.days_ago(5),
    schedule_interval="@daily",
)

fetch_weather_forecast = DummyOperator(task_id="fetch_weather_forecast", dag=dag)
# ... 태스크 7개 정의 후 의존성 연결
fetch_weather_forecast >> clean_forecast_data
fetch_sales_data >> clean_sales_data
[clean_forecast_data, clean_sales_data] >> join_datasets
join_datasets >> train_ml_model >> deploy_ml_model
이 파일을 Airflow 3.3.2 공식 Docker 이미지에서 불러오면 바로 오류가 납니다. 고쳐야 할 곳은 세 군데입니다.
| 책 원본 | Airflow 3.3.2에서 | 이렇게 고침 |
|---|---|---|
from airflow.operators.dummy import DummyOperator |
ModuleNotFoundError |
EmptyOperator로 교체 (airflow.providers.standard.operators.empty) |
airflow.utils.dates.days_ago(5) |
AttributeError (함수가 삭제됨) |
pendulum.datetime(2026, 10, 1)처럼 고정된 날짜 |
schedule_interval="@daily" |
TypeError (인자가 삭제됨) |
schedule="@daily" |
이런 변경을 하나하나 찾을 필요는 없습니다. Airflow는 Airflow 3로 올릴 때 깨지는 코드를 찾는 공식 방법으로 ruff의 AIR 규칙을 안내합니다.
# uv가 설치돼 있다면 설치 없이 바로 실행 (AIR 규칙은 ruff 0.13.1 이상 필요)
uvx ruff@latest check --select AIR3 dags/
책 원본에 돌려 보면 위 세 가지가 모두 잡히고(AIR301·AIR302), 지금은 동작하지만 바꾸길 권하는 from airflow import DAG(AIR311)까지 알려 줍니다. --fix를 붙이면 일부는 자동으로 고쳐 주지만, 남는 옛 import 등은 직접 정리해야 합니다.
다 고친 Airflow 3 버전입니다.
import pendulum

from airflow.providers.standard.operators.empty import EmptyOperator
from airflow.sdk import DAG

with DAG(
    dag_id="01_umbrella",
    description="Umbrella example with EmptyOperators.",
    start_date=pendulum.datetime(2026, 10, 1, tz="Asia/Seoul"),
    schedule="@daily",
):
    fetch_weather_forecast = EmptyOperator(task_id="fetch_weather_forecast")
    fetch_sales_data = EmptyOperator(task_id="fetch_sales_data")
    clean_forecast_data = EmptyOperator(task_id="clean_forecast_data")
    clean_sales_data = EmptyOperator(task_id="clean_sales_data")
    join_datasets = EmptyOperator(task_id="join_datasets")
    train_ml_model = EmptyOperator(task_id="train_ml_model")
    deploy_ml_model = EmptyOperator(task_id="deploy_ml_model")

    fetch_weather_forecast >> clean_forecast_data
    fetch_sales_data >> clean_sales_data
    [clean_forecast_data, clean_sales_data] >> join_datasets
    join_datasets >> train_ml_model >> deploy_ml_model
코드 읽는 법: >>와 [ ]
EmptyOperator는 아무 일도 하지 않는 빈 태스크입니다. 1장 예제는 구조만 보여 주려는 것이라, 실제로 날씨를 가져오거나 모델을 훈련하지는 않습니다.>>는 태스크를 바로 실행하는 코드가 아니라, 실행 순서(의존성)를 정해 두는 문법입니다.a >> b는 "a가 성공하면 b를 시작할 수 있다"는 뜻으로, 화살표 방향 그대로입니다.[a, b] >> c는a >> c와b >> c를 한 줄로 쓴 것입니다. 그래서 "a와 b가 둘 다 성공해야 c를 시작할 수 있다"는 뜻이 됩니다. 대괄호는 여러 태스크를 한 번에 묶는 파이썬 리스트입니다. (앞 태스크가 실패해도 실행되게 하는 등, 이 기본 규칙은 바꿀 수 있습니다. 뒤의 장에서 다룹니다.)
그래서 마지막 네 줄은 고리 네 개가 아니라 의존성을 적은 네 줄입니다. 합치면 태스크 7개와 화살표 6개로 된 DAG 하나, 그림 1.6과 같은 모양이 되고 고리는 하나도 없습니다.
fetch_weather_forecast ──→ clean_forecast_data ──┐
                                                 ├──→ join_datasets ──→ train_ml_model ──→ deploy_ml_model
fetch_sales_data ────────→ clean_sales_data ─────┘
DAG 하나에 태스크가 7개 있고, 하루에 한 번 이 DAG가 실행되면 7개 태스크가 이 순서대로 돕니다. 날씨 줄과 판매 줄은 동시에 돌 수 있고, join_datasets는 두 줄이 다 끝날 때까지 기다립니다.
이 버전은 Airflow 3.3.2에서 문제없이 불러와지고, 태스크 7개와 의존성도 책의 그림과 똑같이 잡힙니다.
직접 돌려 보기
이 글의 실습 코드는 GitHub 저장소 vividbaek/airflow-book-study에 있습니다. Docker만 설치돼 있으면 명령 몇 줄로 Airflow 3.3.2를 띄워 이 DAG를 돌려 볼 수 있습니다.
git clone https://github.com/vividbaek/airflow-book-study.git
cd airflow-book-study
docker compose up
1~2분 뒤(Airflow 이미지를 처음 받을 때는 몇 분 더 걸릴 수 있습니다) 브라우저에서 http://localhost:8080에 들어가면 로그인 없이 Airflow 화면이 열립니다. 01_umbrella DAG는 켜진 상태로 올라와서 바로 한 번 실행되고, DAG를 눌러 보면 태스크 7개가 위 순서대로 성공(초록색)한 걸 확인할 수 있습니다.  (Trigger) 버튼으로 직접 한 번 더 실행해 볼 수도 있습니다. Docker가 없다면 저장소 README의 Codespaces에서 열기로 브라우저에서 바로 실행할 수 있습니다.
직접 띄워 보니, 아무것도 누르지 않았는데 실행이 하나 생겼고 태스크 7개가 5초쯤 만에 모두 성공했습니다. 실행 기록을 보면 fetch_weather_forecast와 fetch_sales_data가 같은 시각에 시작했고, join_datasets는 두 정제 태스크가 모두 끝난 뒤에야 시작했습니다. 이 실행에 붙은 날짜(logical date)는 한국 시간 10월 18일 0시였고, 데이터 구간의 시작과 끝도 같은 시각이었습니다. 웹 UI에도 "최근 실행 2026-10-18 00:00:00"으로 보입니다. 실제로 시작한 건 그날 낮이었지만, 날짜는 스케줄상 예정된 시각으로 붙습니다. Airflow 2였다면 같은 실행에 "10월 17일 몫"이 붙었을 겁니다. 앞에서 본 Airflow 3의 @daily 그대로입니다.
책 예제 25줄에서도 세 군데가 깨집니다. 이 시리즈에서는 앞으로도 각 장의 예제를 Airflow 3에서 직접 돌려 보며, 무엇이 바뀌었는지 저장소에 함께 기록하겠습니다.
 7. 1장을 마치며
처음에 던진 다섯 가지 질문에 답해 보면 이렇습니다.
- DAG는 태스크(점)와 의존성(방향이 있는 화살표)으로 그린, 고리가 없는 그래프입니다. 핵심은 "무엇이 끝나야 무엇을 시작하는가"라는 의존성입니다.
- cron은 "언제 실행할지"만 정하지만, Airflow는 작업을 태스크로 나눠 의존성에 맞춰 실행하고, 실패한 부분만 다시 돌리고, 어느 날짜 몫의 실행인지까지 관리합니다.
- 스케줄러는 결정하고, 워커는 실행하고, 메타스토어는 기록하고, 웹 서버는 보여 줍니다.
- Airflow는 배치 작업을 조율하도록 만들어져서, 한 건씩 바로 처리해야 하는 실시간 처리에는 맞지 않습니다.
- Airflow 3에서는 API 서버·DAG 프로세서로 구조가 바뀌었고,
@daily실행에 붙는 날짜도 달라졌습니다. 책 1장 예제도 세 군데가 깨집니다.
결국 좋은 Airflow 파이프라인은 복잡한 파이썬 문법에서 나오는 것이 아니라, 작업을 어떻게 쪼개고(Task), 어떤 순서로 묶으며(DAG), 어떤 시간 단위로 책임을 나눌 것인가(Schedule & Backfill)에 대한 명확한 정의에서 시작됩니다.
다음 2장(Airflow DAG의 구조)에서는 로켓 발사 데이터를 수집하는 첫 번째 DAG를 작성합니다. 같은 Docker 환경에서 실행 흐름과 실패 처리를 화면으로 확인해 보겠습니다.
이 글은 Apache Airflow 한국 사용자 모임 운영진으로 활동하며 《Apache Airflow 기반의 데이터 파이프라인》을 학습하고, Airflow 3에서 달라진 내용을 더해 정리한 기록입니다. 글을 읽으시며 의견이나 함께 나누고 싶은 인사이트가 있다면 언제든 댓글로 남겨주세요!