TL;DR. 이제 AI를 잘 쓴다는 건 "어느 모델이냐"보다 "모델을 어디서 부르느냐"의 문제입니다. 수천 행에 같은 판정을 독립적으로 내리는 일은 데이터를 밖으로 꺼내지 않고 Snowflake Cortex로 끝내는 게 낫고(외부로 못 내보내는 데이터라면 더욱 그렇습니다) 그 호출의 스케줄, 의존성, 재시도, 백필은 그대로 Airflow가 맡습니다. 이 글은 공시 수천 건 분류와 라이선스 리포트 파싱을 예로,
AI_COMPLETE을SnowflakeHook으로 돌리는 최소 파이프라인을 다룹니다.
AI 모델의 성능이 다들 어느 정도 올라오면서, 이제는 모델의 성능보다 이렇게 훌륭한 모델을 어떻게 도메인에 맞게 잘 활용할지에 더 고민하고 집중하게 되는 것 같습니다. 아무리 좋은 모델이 있어도 내 데이터와 업무에 제대로 붙이지 못하면 결국 의미가 없으니까요.
그 '잘 활용하기’는 대개 같은 모델을 어디서 부를지 정하는 데서 시작합니다.
AI 호출은 성격이 다릅니다. 수백~수천 행에 같은 판정을 독립적으로 내리는 일이 있고, 질의와 결과를 주고받으며 한 건을 깊게 파는 일이 있습니다. 앞쪽은 행이 서로를 참고하지 않는 집합 연산이라 웨어하우스에서 SQL 한 문장으로 돌리는 게 낫고, 뒤쪽은 도구를 쥐고 반복하는 외부 에이전트가 낫습니다.
이 글에서는 그중 앞쪽을 다룹니다. 웨어하우스 안에서 SQL로 AI를 부르고(여기서는 Snowflake Cortex), 그 호출을 Airflow 파이프라인의 태스크로 돌리는 이야기입니다.
예시로 준비한 건 공시 제목 수천 건에 "이건 얼마나 중요한가"를 매기는 일입니다.
제목마다 독립적으로 판정하면 되니 API 루프보다 SQL 한 문장에 맞고, GROUP BY 같은 집합 연산이 비용을 대신 줄여 줍니다.
공시 제목은 공개 데이터라 사실 밖으로 내보내도 되지만, 여기서는 그 배치 경제성 때문에 Cortex로 돌립니다. 반대로 밖으로 내보낼 수 없어서 Cortex를 써야 하는 쪽, 라이센스 리포트가 그런 경우입니다.
전제로, Airflow가 Snowflake에 연결되어 있고, RAW 레이어에 공시나 리서치 리포트가 적재되어 있다고 가정하겠습니다. 커넥션을 만들거나 데이터를 적재하는 방법은 이번 글의 범위에서는 다루지 않습니다.
Snowflake Cortex
Snowflake Cortex는 Snowflake에서 제공하는 AI 기능 모음입니다. 쉽게 생각하면 됩니다. 데이터를 밖으로 꺼내서 별도의 AI 서비스에 보내는 대신, Snowflake 안에서 LLM을 SQL 함수처럼 호출하는 것입니다.
예를 들어 AI_COMPLETE()를 사용하면 일반적인 SQL 함수처럼 사용할 수 있습니다.
SELECT AI_COMPLETE(...)
FROM ...
그래서 별도의 API 서버를 만들거나, 모델 엔드포인트를 관리하거나, API Key를 따로 관리할 필요가 없습니다. 그냥 SQL 안에서 AI를 호출하면 됩니다. 모델도 Snowflake에서 호스팅합니다.
OpenAI, Anthropic, Meta, Mistral, DeepSeek 등의 모델을 선택해서 사용할 수 있고, 예제에서는 Anthropic의 Claude(claude-sonnet-4-6)를 사용하겠습니다.
여기서 중요한 건 단순히 "SQL에서 AI를 호출할 수 있다"는 점만은 아닙니다. 데이터가 어디에서 처리되는가도 상당히 중요합니다. 특히 외부로 데이터를 보내기 어려운 환경에서는 더 그렇습니다.
Cortex에는 SQL에서 사용하는 AI Functions 외에도 자연어를 SQL로 바꾸는 Cortex Analyst, 검색을 위한 Cortex Search, 여러 도구를 사용하면서 작업을 수행하는 Cortex Agents 등이 있습니다. 하지만 이번 글에서는 이 중에서 SQL 함수로 AI를 호출하는 부분에 집중하겠습니다.
왜 Cortex인가
사실 공시 제목만 가지고 보면 굳이 Cortex를 써야 할 이유는 크지 않습니다. 공시 제목은 공개 데이터이기 때문에 외부 모델 API로 보내도 데이터 자체가 문제가 되지는 않습니다.
그런데 리서치 리포트라면 이야기가 달라집니다. 라이센스를 가지고 있는 리서치 리포트는 계약상 외부로 데이터를 전송할 수 없는 경우가 있습니다. 이런 데이터를 외부 AI API에 그대로 보내면 문제가 될 수 있습니다. 그래서 이런 경우에는 데이터를 밖으로 꺼내지 않고 데이터가 있는 곳에서 AI를 호출하는 방식이 훨씬 적합합니다.
Snowflake는 Cortex의 모델이 Snowflake의 보안 및 거버넌스 경계 안에서 동작하고, 고객 데이터가 모델 학습에 사용되지 않는다는 내용을 문서로 제공하고 있습니다. 또한 접근 권한은 Snowflake의 RBAC를 통해 관리할 수 있습니다.
그런데 또 단순히 보안 때문만은 아닙니다. 실제로 데이터를 많이 처리해보면 SQL 안에서 AI를 호출할 수 있다는 것 자체가 꽤 편합니다. 예를 들어 GROUP BY, JOIN, WHERE 같은 기존 SQL 연산과 AI 호출을 그대로 조합할 수 있습니다.
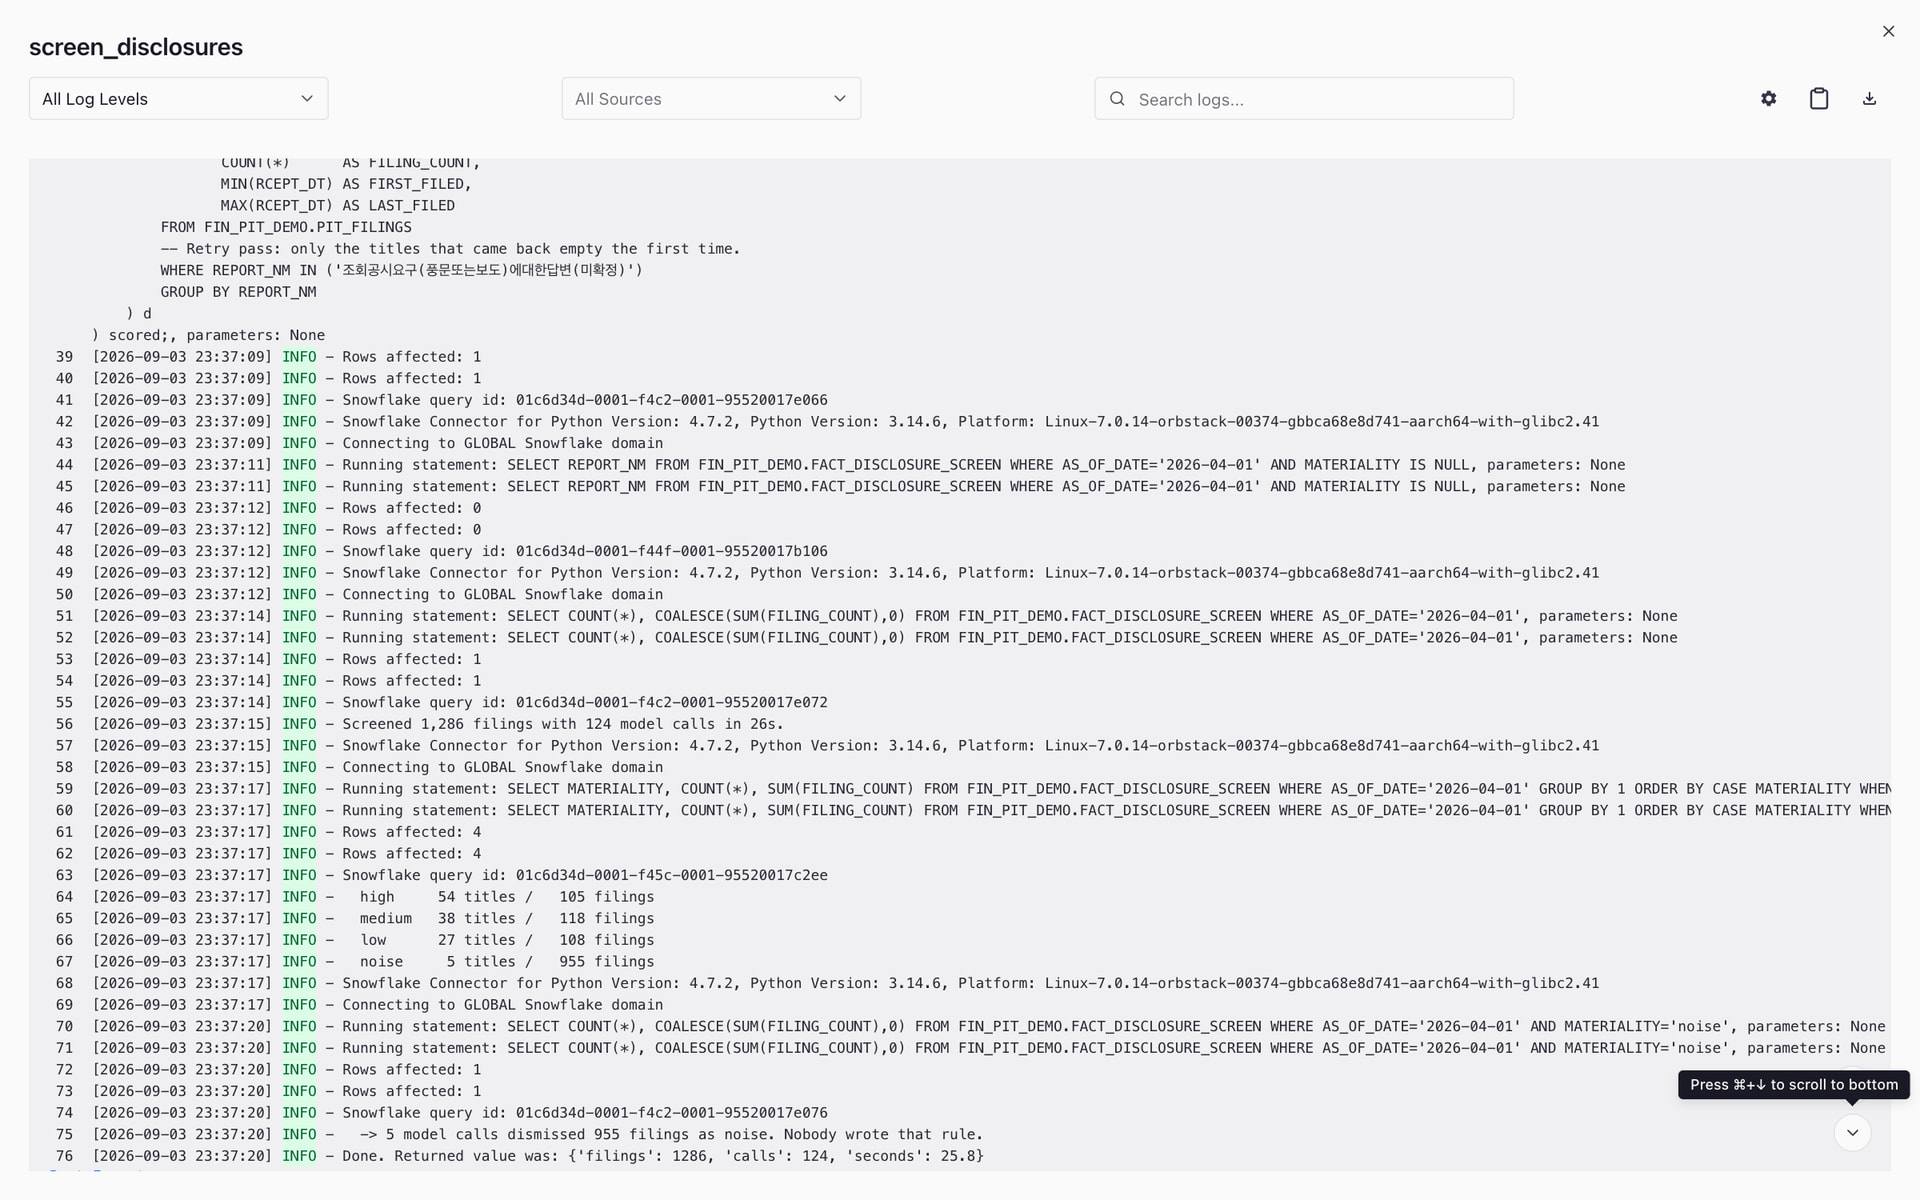
공시 분류가 좋은 예입니다. 1,286건의 공시가 있지만 실제로는 124개의 고유한 공시 제목만 있다면 굳이 AI를 1,286번 호출할 필요가 없습니다. 먼저 GROUP BY로 제목을 묶고, 124번만 AI를 호출하면 됩니다.
이런 데이터 가공을 애플리케이션에서 직접 구현하려면 deduplication부터 배치 처리, rate limit, retry, 부분 실패 처리까지 직접 만들어야 합니다. 그런데 Snowflake에서는 그냥 SQL로 처리할 수 있습니다. 그리고 쿼리는 QUERY_HISTORY에 남기 때문에 실행에 대한 추적도 할 수 있습니다.
반대로 Cortex가 모든 AI 작업에 적합한 것은 아닙니다. AI_COMPLETE는 기본적으로 한 번의 호출로 결과를 받는 형태입니다. 도구를 사용하고, 결과를 보고, 다시 질문하고, 또 다른 도구를 호출하는 식의 복잡한 에이전트 작업에는 적합하지 않습니다.
그래서 결국 AI를 사용하는 경로를 두 가지로 나누어 생각할 필요가 있습니다.
대량의 독립적인 데이터 처리 → Snowflake Cortex
한 건을 깊게 파고드는 작업 → Agent
이번 글에서는 앞쪽을 다룹니다.
그리고 이런 데이터는 리서치 리포트만 있는 것도 아닙니다. 개인정보, 고객 계약서, 진료기록, 사내 소스코드처럼 가지고는 있지만 외부로 보낼 권한이 없는 데이터는 어느 조직에나 있을 수 있습니다.
Cortex 켜기
Cortex AI Functions를 사용하려면 관련 권한이 필요합니다.
Cortex AI 함수를 부르려면 역할에 USE AI FUNCTIONS 계정 레벨 권한과 SNOWFLAKE.CORTEX_USER(또는 AI_FUNCTIONS_USER) 데이터베이스 롤이 둘 다 있어야 합니다.
둘 다 기본적으로 PUBLIC 역할에 부여돼 있어서, 갓 만든 계정은 별도 GRANT 없이도 Cortex를 부를 수 있습니다. 이 데모는 PUBLIC에 기대는 대신 전용 AIRFLOW_ROLE에 CORTEX_USER를 직접 부여합니다(최소 권한). 함수는 일부 리전에서만 기본 제공되니, 계정 리전에 없는 모델은 cross-region inference로 씁니다.
GRANT DATABASE ROLE SNOWFLAKE.CORTEX_USER TO ROLE AIRFLOW_ROLE;   --> 커넥션 역할에 권한 (관리자가 1회)
ALTER ACCOUNT SET CORTEX_ENABLED_CROSS_REGION = 'ANY_REGION';     --> 리전에 모델이 없으면
여기서 하나 주의할 점이 있습니다. Cortex를 사용할 수 있는 권한과 어떤 모델을 사용할 수 있는지는 별개의 문제입니다.
예전에는 CORTEX_MODELS_ALLOWLIST 같은 계정 파라미터를 사용했지만, 현재는 Model RBAC 방식으로 변경되고 있습니다. 이건 BCR-2378로 사용 중지되고 Model RBAC 방식으로 변경되고 있습니다.
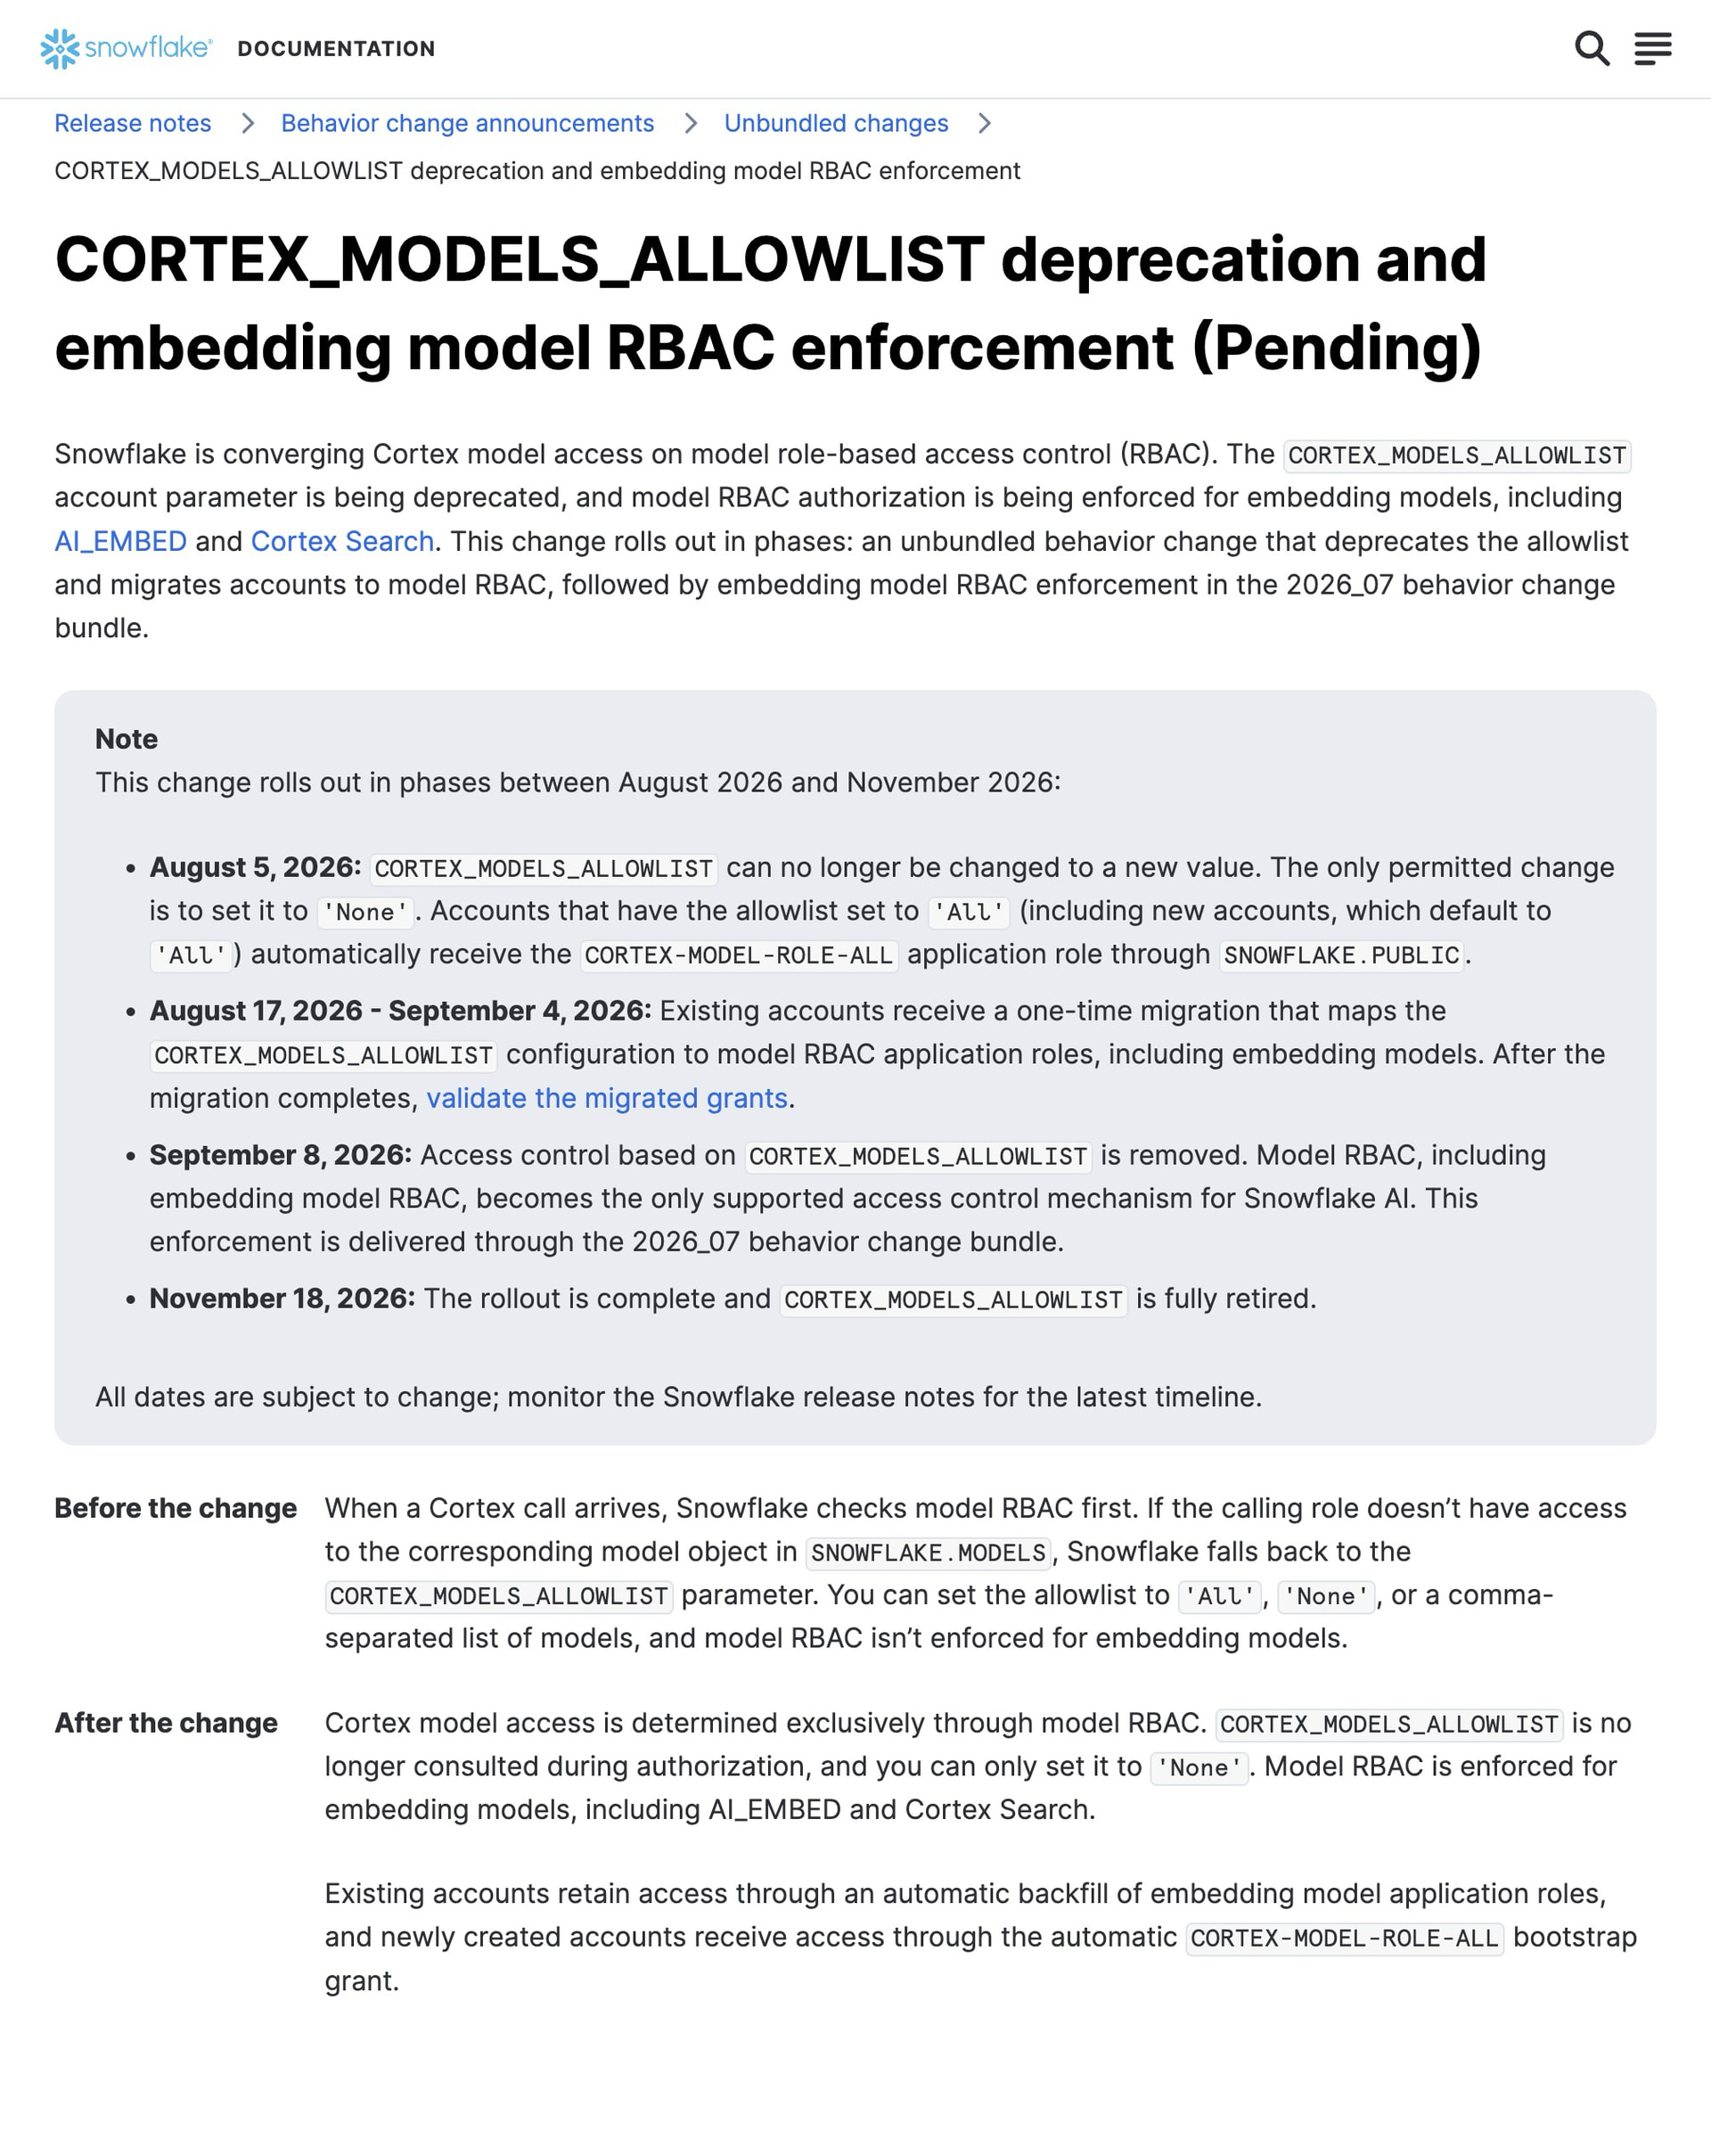
allowlist가 ALL인 계정(새 계정 기본값)은 CORTEX-MODEL-ROLE-ALL 애플리케이션 롤이 PUBLIC에 자동 부여돼 모든 모델이 열리니 대개 손댈 게 없고, 최소 권한으로 좁히려면 역할에 모델별 롤(CORTEX-MODEL-ROLE-<모델>)만 붙입니다. 임베딩 함수(AI_EMBED)는 함수 권한으로 CORTEX_USER나 CORTEX_EMBED_USER가 필요한데, 뒤엣것은 CORTEX_USER와 달리 PUBLIC 기본이 아닙니다.
따라서 실제로 사용할 모델이 현재 계정과 리전에서 지원되는지는 먼저 확인하는 것이 좋습니다. 그래서 쓰려는 모델이 계정 리전에 있는지는 모델 가용성으로 확인하고 처음부터 복잡한 SQL을 돌리기보다는 AI_COMPLETE 한 줄부터 실행해보는 것을 추천합니다.
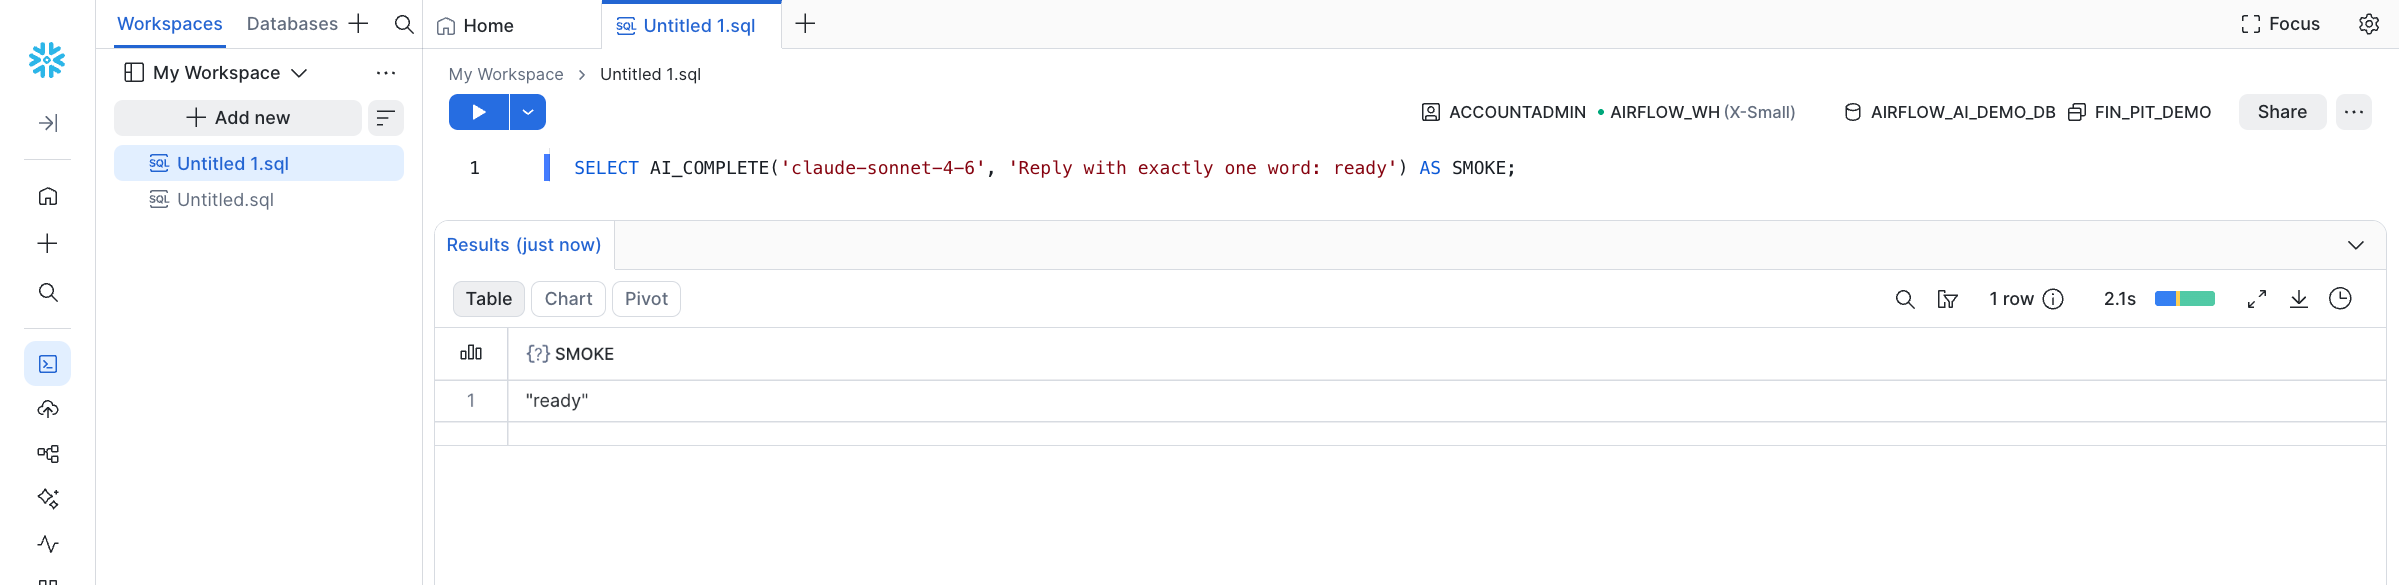
이게 정상적으로 돌아가면 일단 Cortex 자체는 사용할 수 있다고 보면 됩니다.
공시 수천 건을 한 문장으로 분류하기
이제 실제로 해보겠습니다. 공시 제목마다 중요도를 판단한다고 해보겠습니다.
우리가 원하는 결과는 대략 이런 형태입니다.
category
materiality
why
그리고 materiality는 다음과 같이 나눠보겠습니다.
high
medium
low
noise
여기서 AI_COMPLETE를 사용하면 됩니다.
SELECT
    d.REPORT_NM,
    d.FILING_COUNT,
    AI_COMPLETE(
        model  => 'claude-sonnet-4-6',
        prompt => 'You are screening Korean regulatory disclosure titles ...'
               || '공시명: ' || d.REPORT_NM,
        response_format => {
            'type': 'json',
            'schema': { 'type': 'object', 'properties': {
                'category':    { 'type': 'string', 'enum': ['정기보고서','지분변동','자본거래','영업투자','지배구조','시장조치','기타'] },
                'materiality': { 'type': 'string', 'enum': ['high','medium','low','noise'] },
                'why':         { 'type': 'string' }
            }, 'required': ['category','materiality','why'] }
        }
    ) AS V
FROM (
    SELECT REPORT_NM, COUNT(*) AS FILING_COUNT,
           MIN(RCEPT_DT) FIRST_FILED, MAX(RCEPT_DT) LAST_FILED
    FROM {{ params.source_table }}
    GROUP BY REPORT_NM
) d
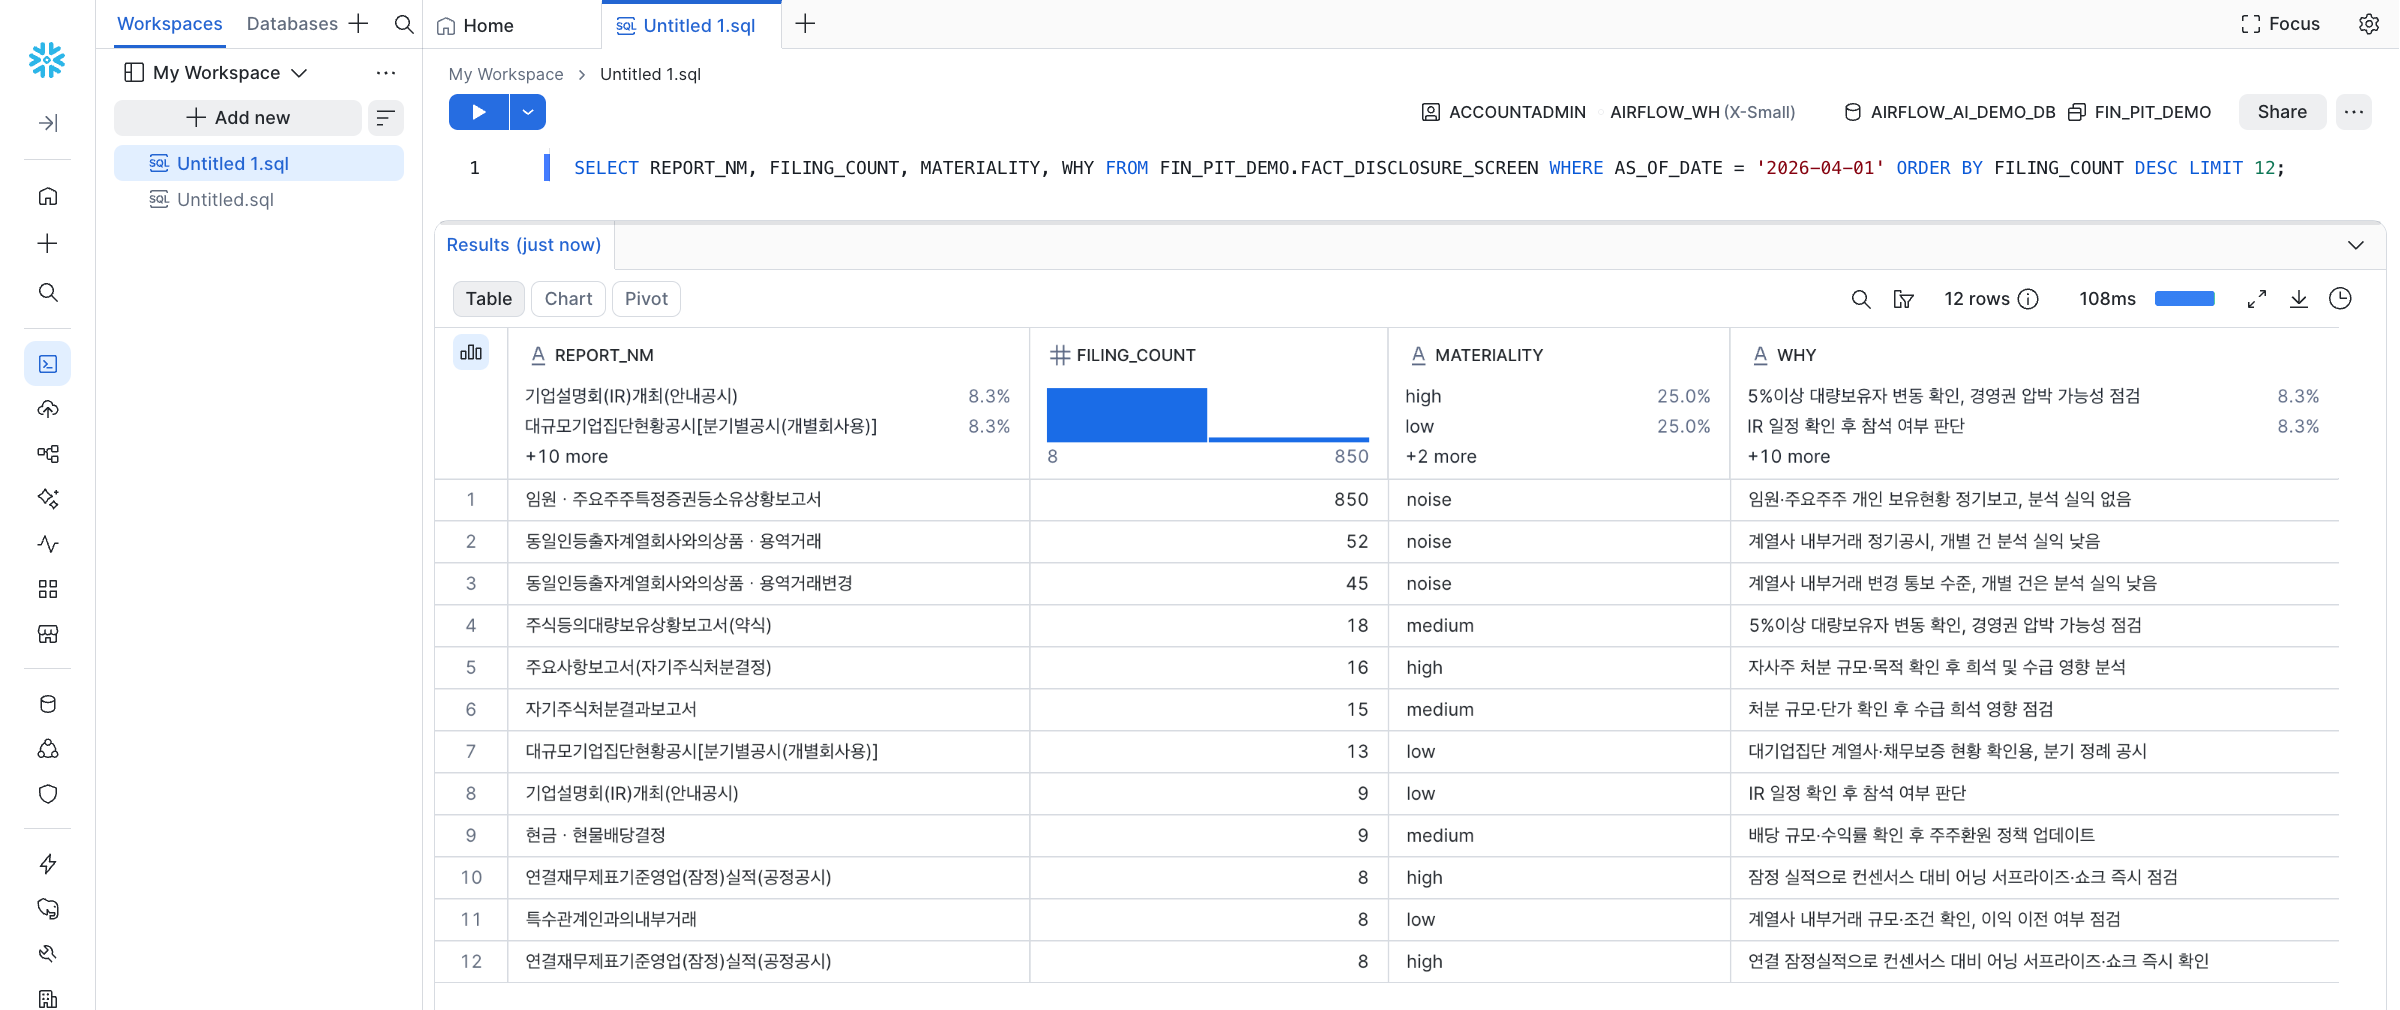
여기서 중요한 부분은 GROUP BY입니다. 1,286건의 공시가 실은 124개의 고유 제목만 갖고 있어서(그중 850건이 같은 지분보고), 모델을 1,286번이 아니라 124번 부릅니다. “어떤 유형이 노이즈인가” 규칙 목록은 아무도 손으로 짜지 않았습니다. 제목마다 한 번 판정하면 같은 제목의 나머지 공시가 그 판정을 물려받습니다.
이걸 웨어하우스 밖에서 하려면 저 dedup을 손으로 짜고, 배치, 레이트리밋 백오프, 부분 실패 재시도까지 다 만들어야 합니다. 여기서는 SELECT 하나입니다.
그리고 response_format에 JSON Schema를 지정했기 때문에 AI의 결과를 다시 애플리케이션 코드에서 파싱할 필요도 없습니다.
결과 자체를 컬럼처럼 사용할 수 있습니다. 노이즈로 분류된 공시는 제목 5개가 955건의 공시에 해당했습니다.
전체 1,286건 중 약 4분의 3입니다. 즉, 사람이 직접 확인해야 할 목록을 상당히 줄일 수 있습니다.
모델 옵션과 토큰
AI_COMPLETE는 model, prompt 말고도 선택 인자를 받습니다. 프롬프트는 그대로 두고 호출의 성질만 조절할 때 씁니다.
model_parameters는 모델 하이퍼파라미터를 담는 객체입니다.
temperature(0~1, 기본 0): 출력의 무작위성. 낮을수록 같은 입력에 같은 답이 나오고, 높을수록 다양해집니다. 분류, 추출처럼 정답이 하나인 작업은0, 문안을 여러 개 뽑는 작업은 0.7쯤을 씁니다.top_p(0~1, 기본 0):temperature의 대안. 확률 상위 토큰만 후보로 남깁니다. 보통 둘 중 하나만 건드립니다.max_tokens(기본 4096): 출력 토큰 상한. 낮으면 응답이 잘립니다.guardrails(기본 false):true면 Cortex Guard(Meta Llama Guard 3)가 폭력, 혐오, 자해 같은 유해 응답을 걸러냅니다.
이 값들은 답의 성향, 길이, 안전성을 바꿀 뿐 사실을 보장하지 않습니다. temperature: 0은 "매번 같은 답"이지 "맞는 답"이 아니고(그래서 재질의, 검증이 필요합니다), max_tokens를 늘려도 더 정확해지지 않으며, guardrails는 유해 표현을 거를 뿐 오답은 못 거릅니다.
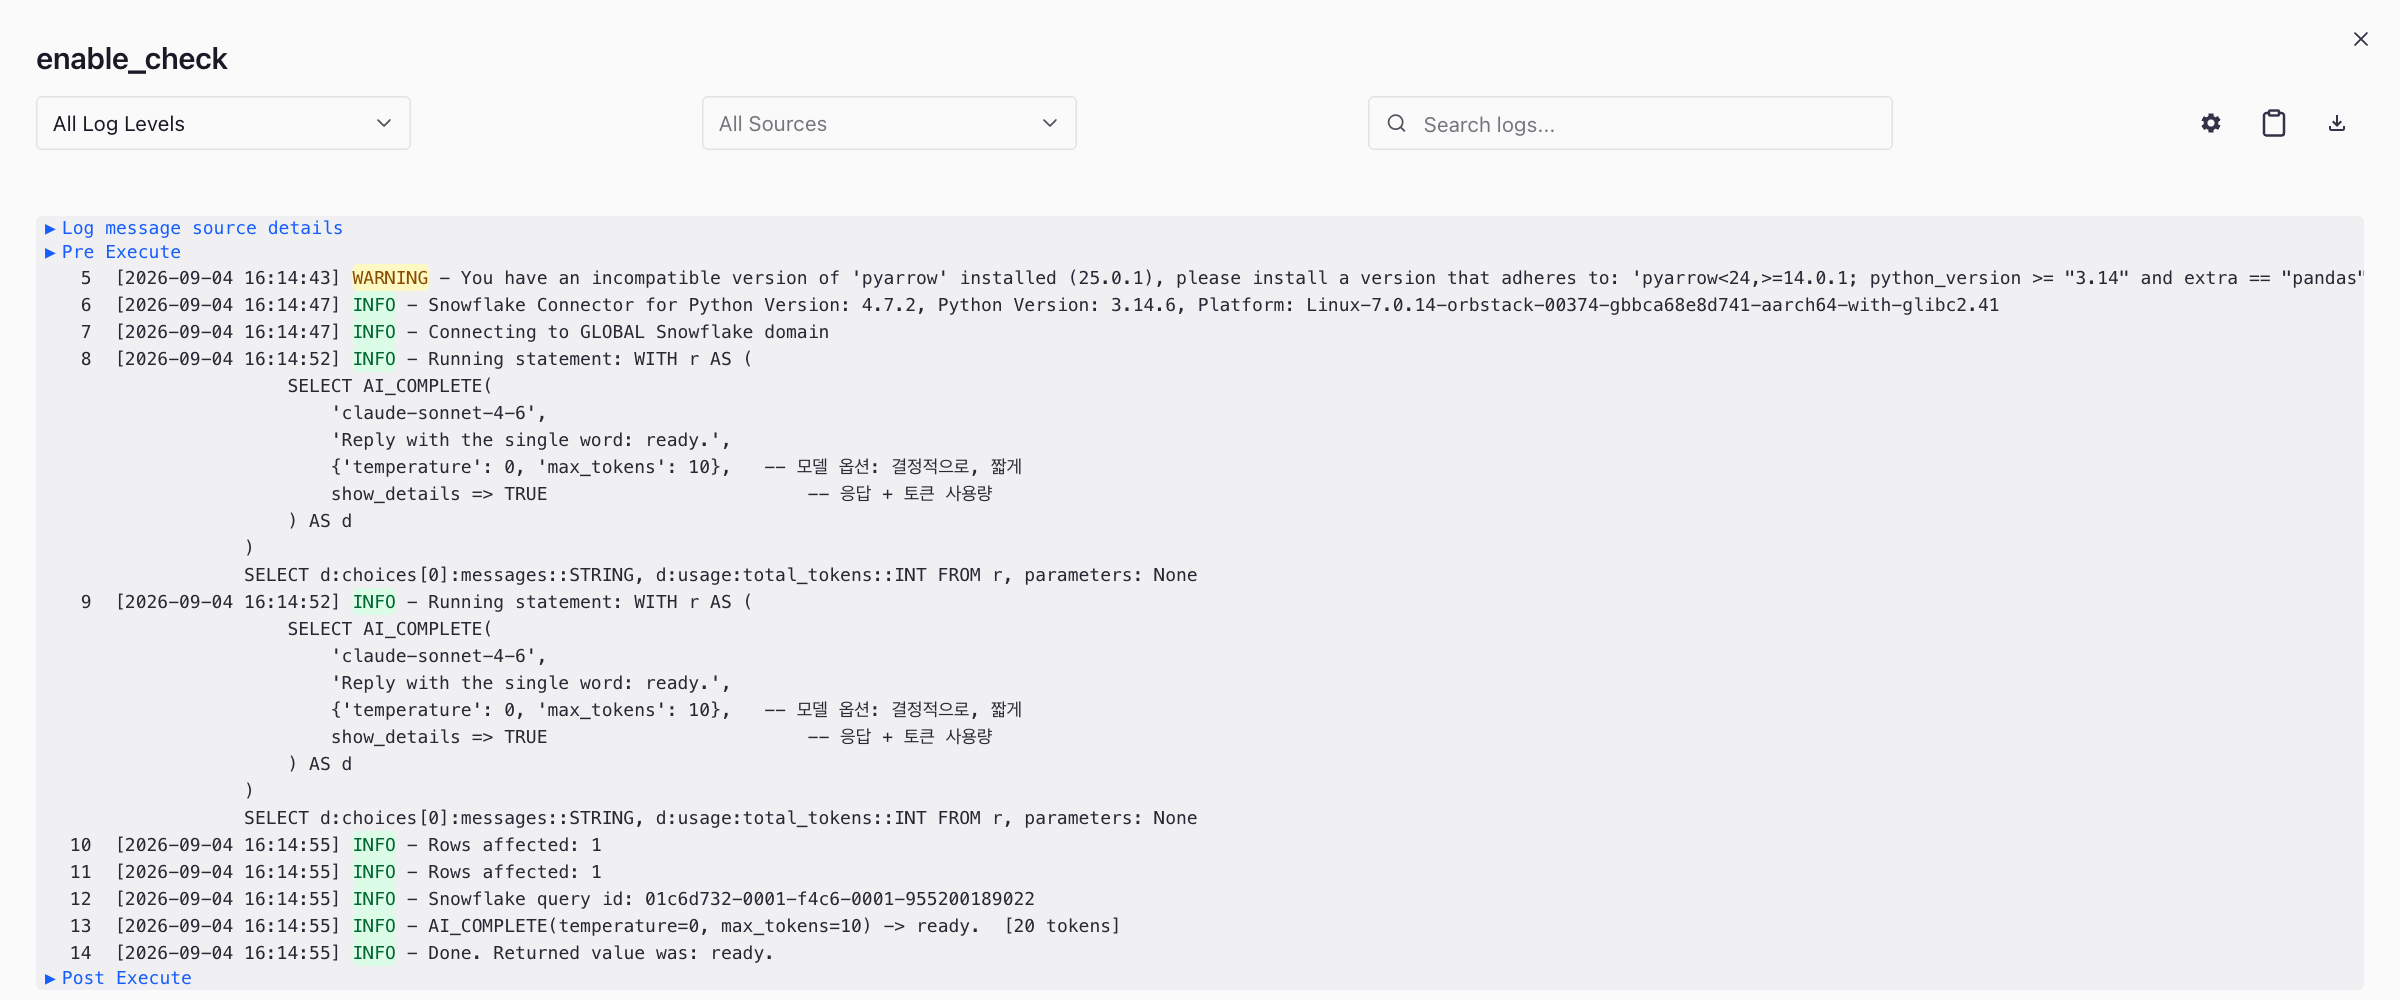
show_details => TRUE를 얹으면 응답과 함께 토큰 사용량이 돌아옵니다. 프롬프트, 출력 토큰을 그대로 받아 호출당 비용을 잽니다.
SELECT AI_COMPLETE(
    model  => 'claude-sonnet-4-6',
    prompt => 'Reply with the single word: ready.',
    model_parameters => { 'temperature': 0, 'max_tokens': 10 },
    show_details     => TRUE
):usage:total_tokens::INT AS tokens;
Airflow가 여기서 하는 일
Cortex 호출이 SQL 한 문장이면 워크시트에서 그냥 돌려도 될 텐데, 왜 Airflow에 넣을까요. 공시는 매일 쌓이고 리포트는 계속 나오니 스크리닝도 파싱도 한 번으로 끝이 아니라 기준일마다 다시 돌아야 하고, RAW 적재가 끝난 뒤에 돌아 그 결과를 다음 단계가 받습니다.
판정이 빈 행을 다시 물어 완결을 보장하고, 재실행은 멱등해야 하며, 기준일별 백필이 과거를 다시 걷는 일이 됩니다. 스케줄, 의존성, 재시도, 멱등은 전부 오케스트레이터의 몫입니다.
Cortex를 Airflow에서 쓰는 데는 AI 전용 오퍼레이터가 없이 SnowflakeHook으로 SQL을 실행하는, 원래 쓰던 그 방식 그대로입니다. 이 글의 네 단계를 그대로 담은 예제 Dag에서 분류 태스크만 떼면 이렇습니다.
#  공시 분류 태스크
from airflow.sdk import task
from airflow.providers.snowflake.hooks.snowflake import SnowflakeHook

SNOWFLAKE_CONN_ID = "snowflake_default"
CORTEX_MODEL      = "claude-sonnet-4-6"
SCREEN_SQL        = INCLUDE_DIR / "sql" / "cortex_screen_disclosures.sql"

def _render(path, **params) -> str:            # SQL 파일의 {{ params.* }}를 채운다
    from jinja2 import Template
    return Template(path.read_text(encoding="utf-8")).render(params=params)

@task
def screen_disclosures(as_of: str) -> dict:
    hook = SnowflakeHook(snowflake_conn_id=SNOWFLAKE_CONN_ID)
    hook.run(f"DELETE FROM {FACT_DISCLOSURE_SCREEN} WHERE AS_OF_DATE = '{as_of}'")

    def sql(only=None) -> str:
        return _render(
            SCREEN_SQL,
            cortex_model=CORTEX_MODEL,          # 모델은 코드가 아니라 파라미터
            as_of_date=as_of,
            source_table=PIT_FILINGS,           # 기준일에 보이던 공시만
            target_table=FACT_DISCLOSURE_SCREEN,
            only_titles=", ".join("'" + t.replace("'", "''") + "'" for t in only) if only else "",
        )

    hook.run(sql())                            # 모델 호출이지만 Airflow가 보기엔 SQL 실행
모델 호출은 문장 안(AI_COMPLETE)에서 웨어하우스가 하고, Airflow는 SQL을 렌더링해 보내고 결과를 받을 뿐입니다. 모델명도 SQL에 박지 않고 CORTEX_MODEL 한 곳에서 파라미터로 넣어서, 모델을 바꿔도 SQL은 그대로고 결과 테이블에는 어떤 모델이 판정했는지가 남습니다(스크리닝 SQL의 SCREENED_BY).
Grid View와 Graph View로 보면 파이프라인 전체와 이 태스크의 자리가 한눈에 들어옵니다.
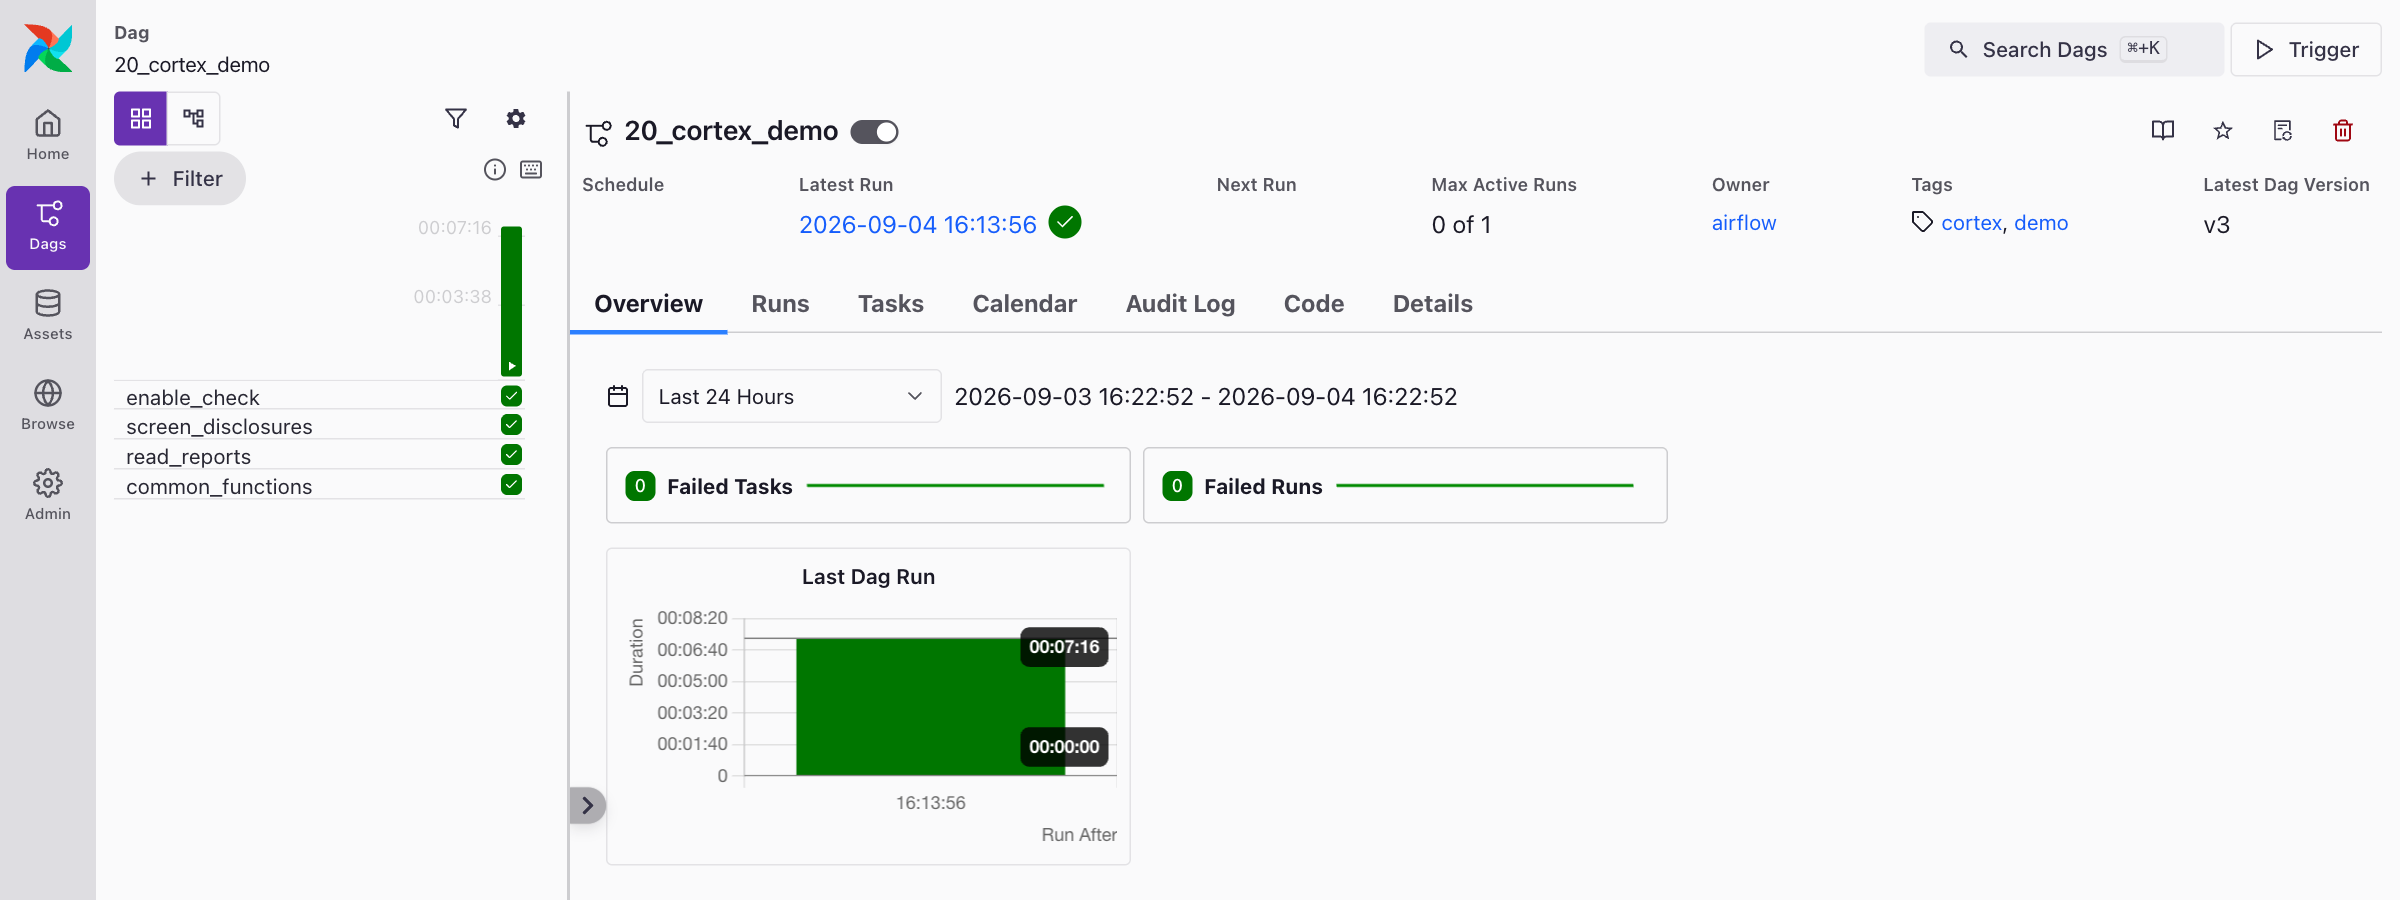
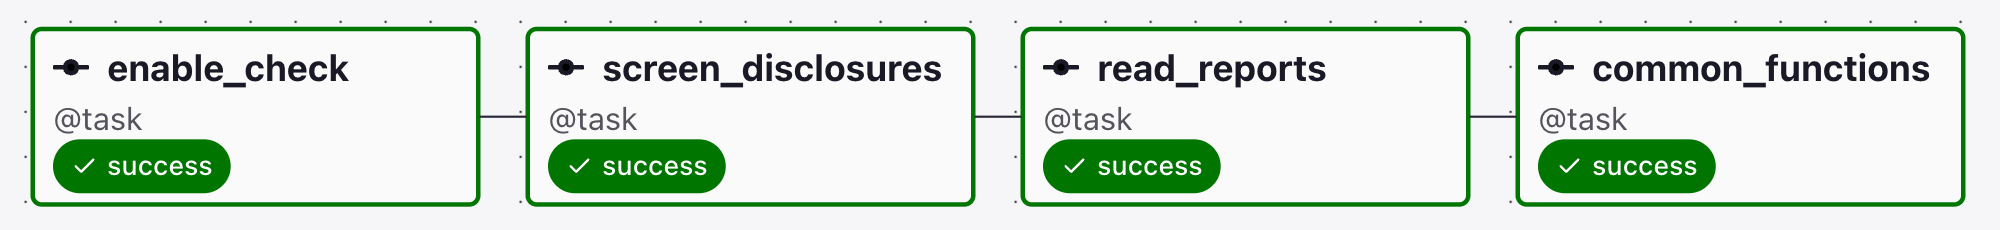
기준일 파티션을 먼저 지우는 첫 줄이 재실행을 멱등하게 만듭니다. 그 위에 얹히는 로직은 하나뿐입니다. AI_COMPLETE는 큰 배치에서 개별 행에 NULL을 돌려줘도 문장 자체는 성공하는데, “실행은 초록불인데 답이 틀린” 그 집합 버전입니다. 그래서 판정이 빈 제목만 골라 다시 질의하고, 그래도 남으면 Dag를 실패시킵니다. 행이 왜 비었는지까지 알아야 할 땐 AI_COMPLETE에 return_error_details => TRUE를 주면, 값과 에러 메시지를 담은 객체가 행마다 돌아옵니다.
for attempt in range(1, SCREEN_RETRIES + 1):
    missing = [r[0] for r in hook.get_records(
        f"SELECT REPORT_NM FROM {FACT_DISCLOSURE_SCREEN} "
        f"WHERE AS_OF_DATE='{as_of}' AND MATERIALITY IS NULL")]
    if not missing:
        break
    hook.run(f"DELETE FROM {FACT_DISCLOSURE_SCREEN} "
             f"WHERE AS_OF_DATE='{as_of}' AND MATERIALITY IS NULL")
    hook.run(sql(only=missing))                # 빈 제목만 지우고 다시 질의
else:
    raise AirflowFailException("screen incomplete")   # 부분 목록으론 다음 단계가 진행될 수 없다
이 태스크가 남기는 건 로그에 그대로 있습니다. 렌더된 SQL, 스크리닝 요약, 그리고 판정이 빈 제목 하나를 다시 물은 재시도 패스까지.
라이센스 리포트를 웨어하우스 밖으로 안 꺼내고 읽기
밖으로 보낼 수 없는 PDF 리포트를 읽어야 할 때가 있습니다. 이때 Airflow는 PDF를 열지 않습니다. 바이트만 읽어 스테이지에 PUT하고, 읽는 일은 Snowflake의 SNOWFLAKE.CORTEX.PARSE_DOCUMENT가 LAYOUT 모드로 웨어하우스 안에서 합니다.
hook.run(f"PUT 'file://{path}' @{RESEARCH_STAGE} AUTO_COMPRESS=FALSE OVERWRITE=TRUE")
hook.run(f"ALTER STAGE {RESEARCH_STAGE} REFRESH")
-- PDF를 웨어하우스 안에서 파싱하고, 결과 DOC에서 컬럼을 꺼낸다
WITH parsed AS (
    SELECT SNOWFLAKE.CORTEX.PARSE_DOCUMENT(
               @{{ params.stage }}, RELATIVE_PATH, {'mode': 'LAYOUT'}
           ) AS DOC
    FROM DIRECTORY(@{{ params.stage }})
)
SELECT
    DOC:content::STRING             AS FULL_TEXT,    -- 본문: 웨어하우스에 남는다
    DOC:metadata:pageCount::NUMBER  AS PAGE_COUNT,   -- 스크린샷의 페이지 수
    LENGTH(DOC:content::STRING)     AS CHAR_COUNT    -- 스크린샷의 글자 수
FROM parsed;
PUT도 이 파싱 SQL도 앞의 분류와 똑같은 SnowflakeHook이 보냅니다(파싱 SQL은 _render로 렌더링해서). Airflow는 파일을 옮기고 SQL을 보낼 뿐입니다. 그래서 리포트 본문이 오케스트레이터 메모리에 올라오지 않고, requirements.txt에서 pypdf 같은 파싱 의존성도 사라집니다. LAYOUT 모드는 표, 제목 구조를 남겨서, 추출 모델이 차트 라벨 더미 대신 글의 논지를 읽습니다. 리포트 본문은 정확히 한 시스템 안에만 존재하게 됩니다.
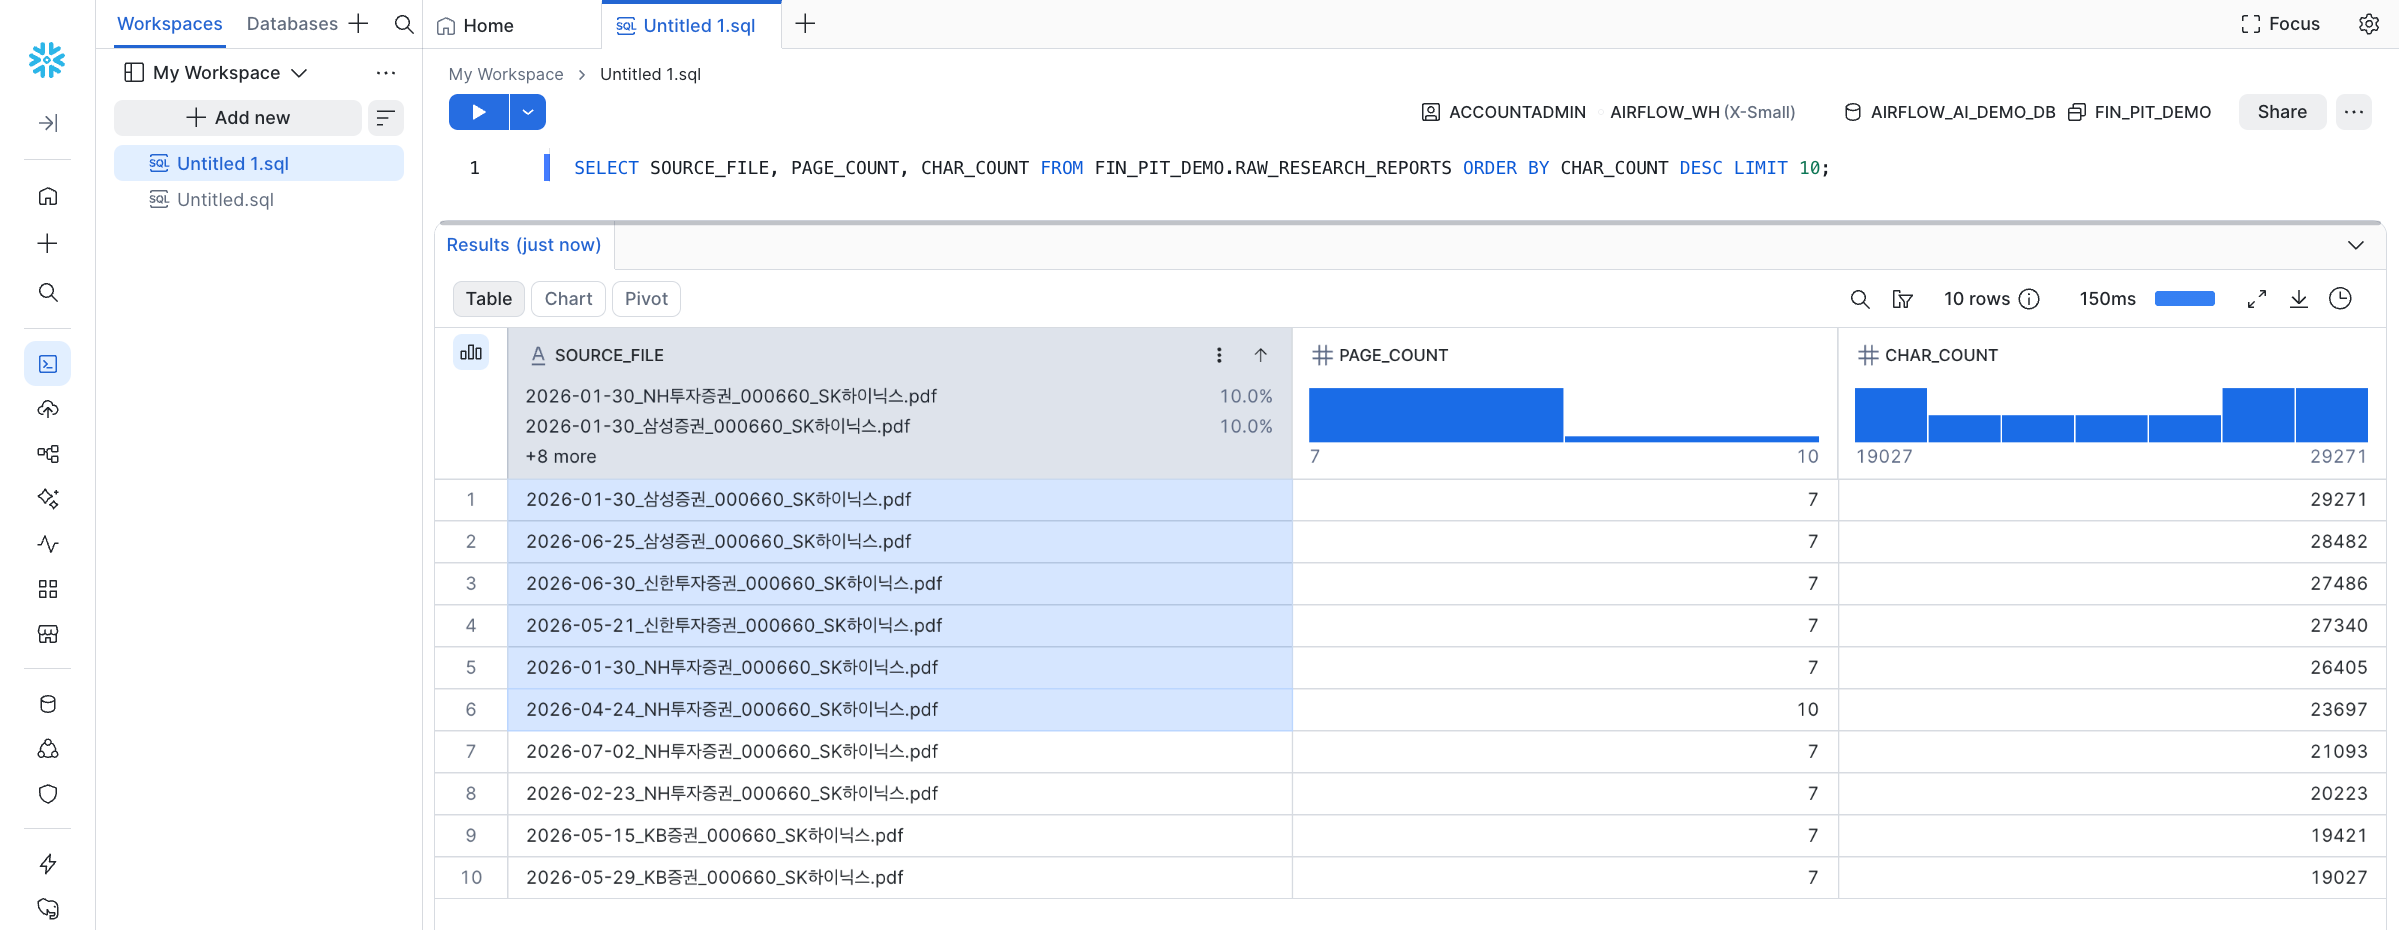
이 파싱도 read_reports 태스크로 Airflow에서 돌고, 로그엔 나온 것만 남습니다. 페이지 수와 글자 수뿐입니다.

자주 사용되는 작업엔 전용 함수가 있습니다
앞서 공시 제목을 분류할 때는 AI_COMPLETE에 JSON 스키마를 물려 형식을 강제했습니다.
출력 형식을 직접 정해야 할 때는 그게 맞지만, 분류, 필터, 번역, 감성처럼 굳은 작업은 스키마도 프롬프트도 없이 전용 함수 한 줄로 끝납니다. 아래 예제는 워크시트에서 바로 돌려볼 수 있고, 파이프라인에 넣을 땐 앞과 똑같이 hook.run()으로 실행합니다.
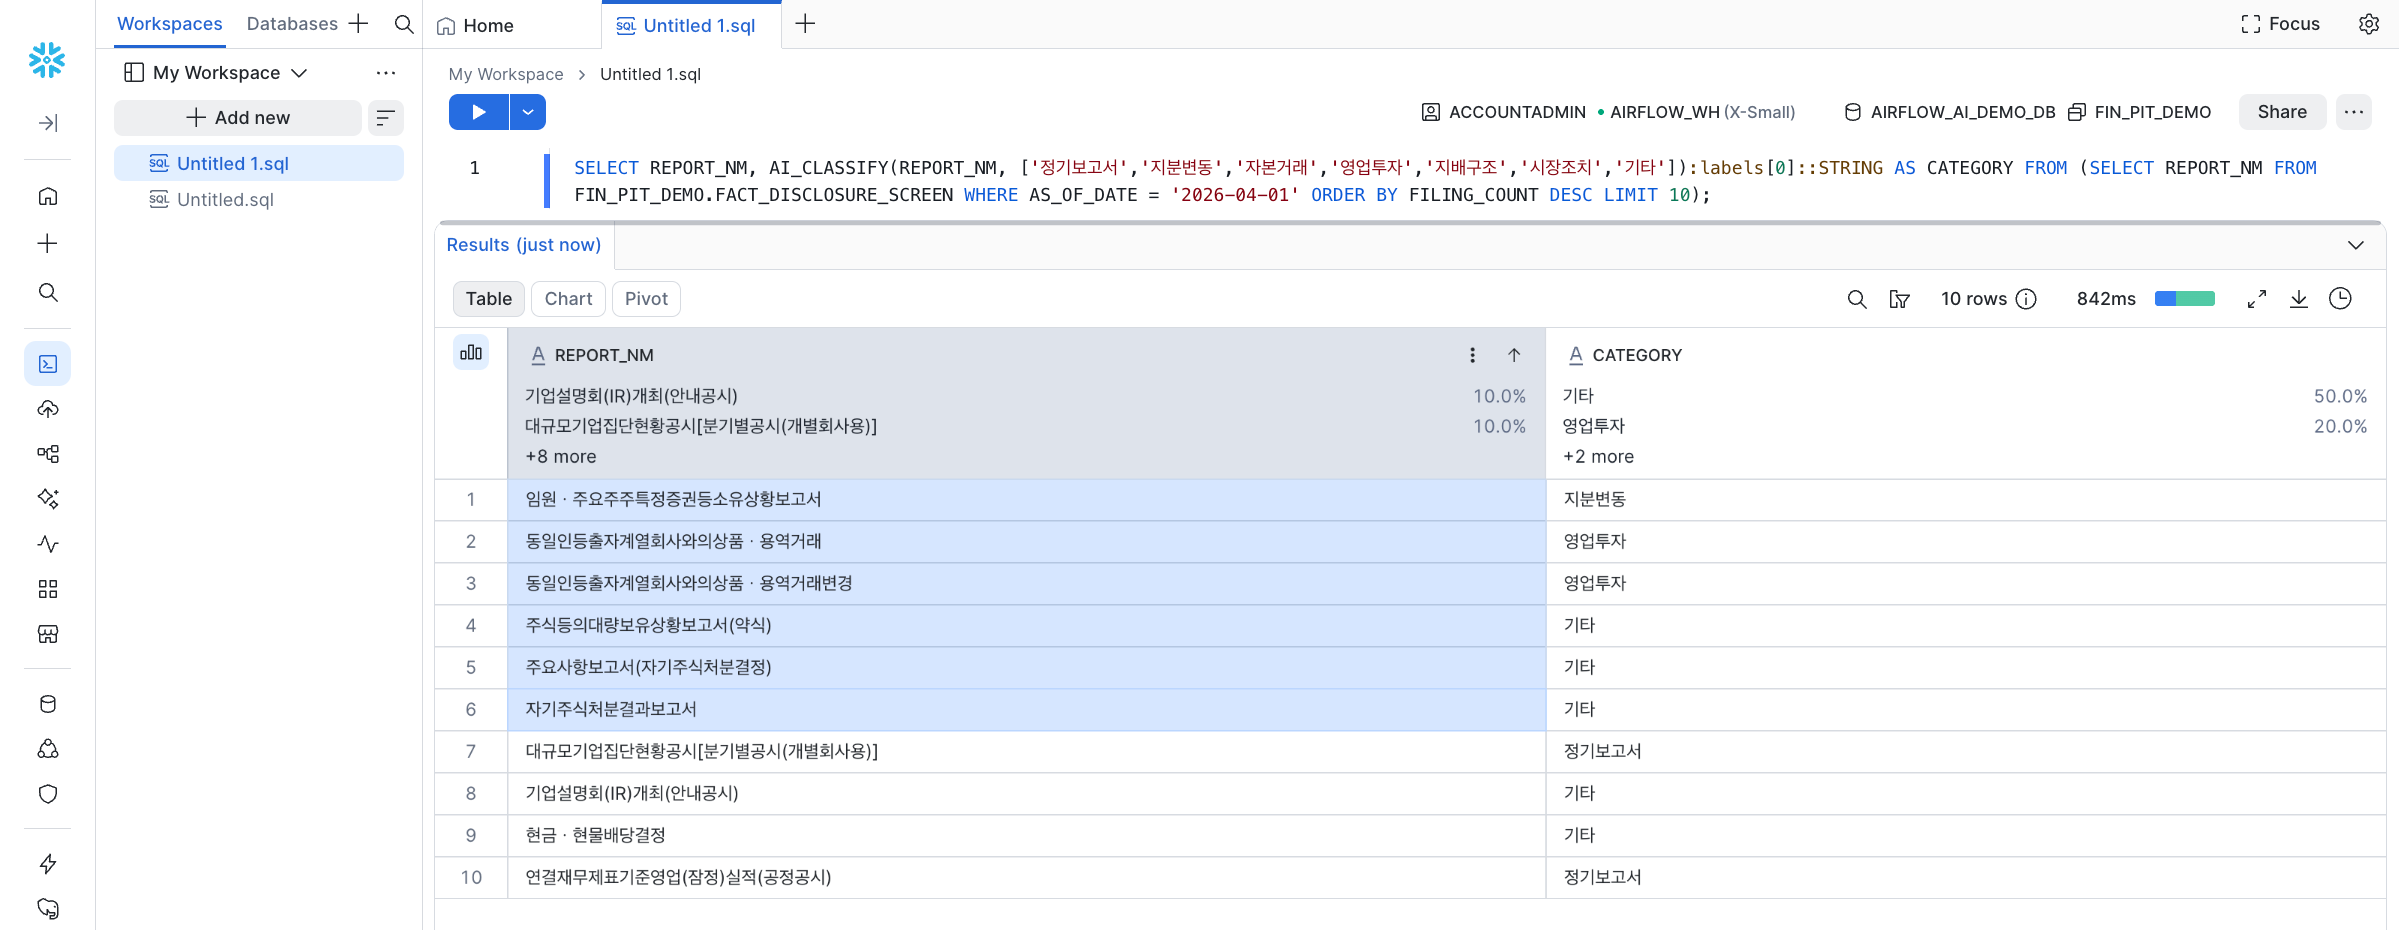
AI_CLASSIFY는 카테고리 목록만 넘기면 라벨을 돌려줍니다. 분류에서 프롬프트로 시키던 일을 함수 하나가 합니다.
SELECT REPORT_NM,
       AI_CLASSIFY(REPORT_NM,
         ['정기보고서','지분변동','자본거래','영업투자','지배구조','시장조치','기타']
       ):labels[0]::STRING AS CATEGORY
FROM (SELECT REPORT_NM FROM FIN_PIT_DEMO.FACT_DISCLOSURE_SCREEN
      WHERE AS_OF_DATE = '2026-04-01' ORDER BY FILING_COUNT DESC LIMIT 10);
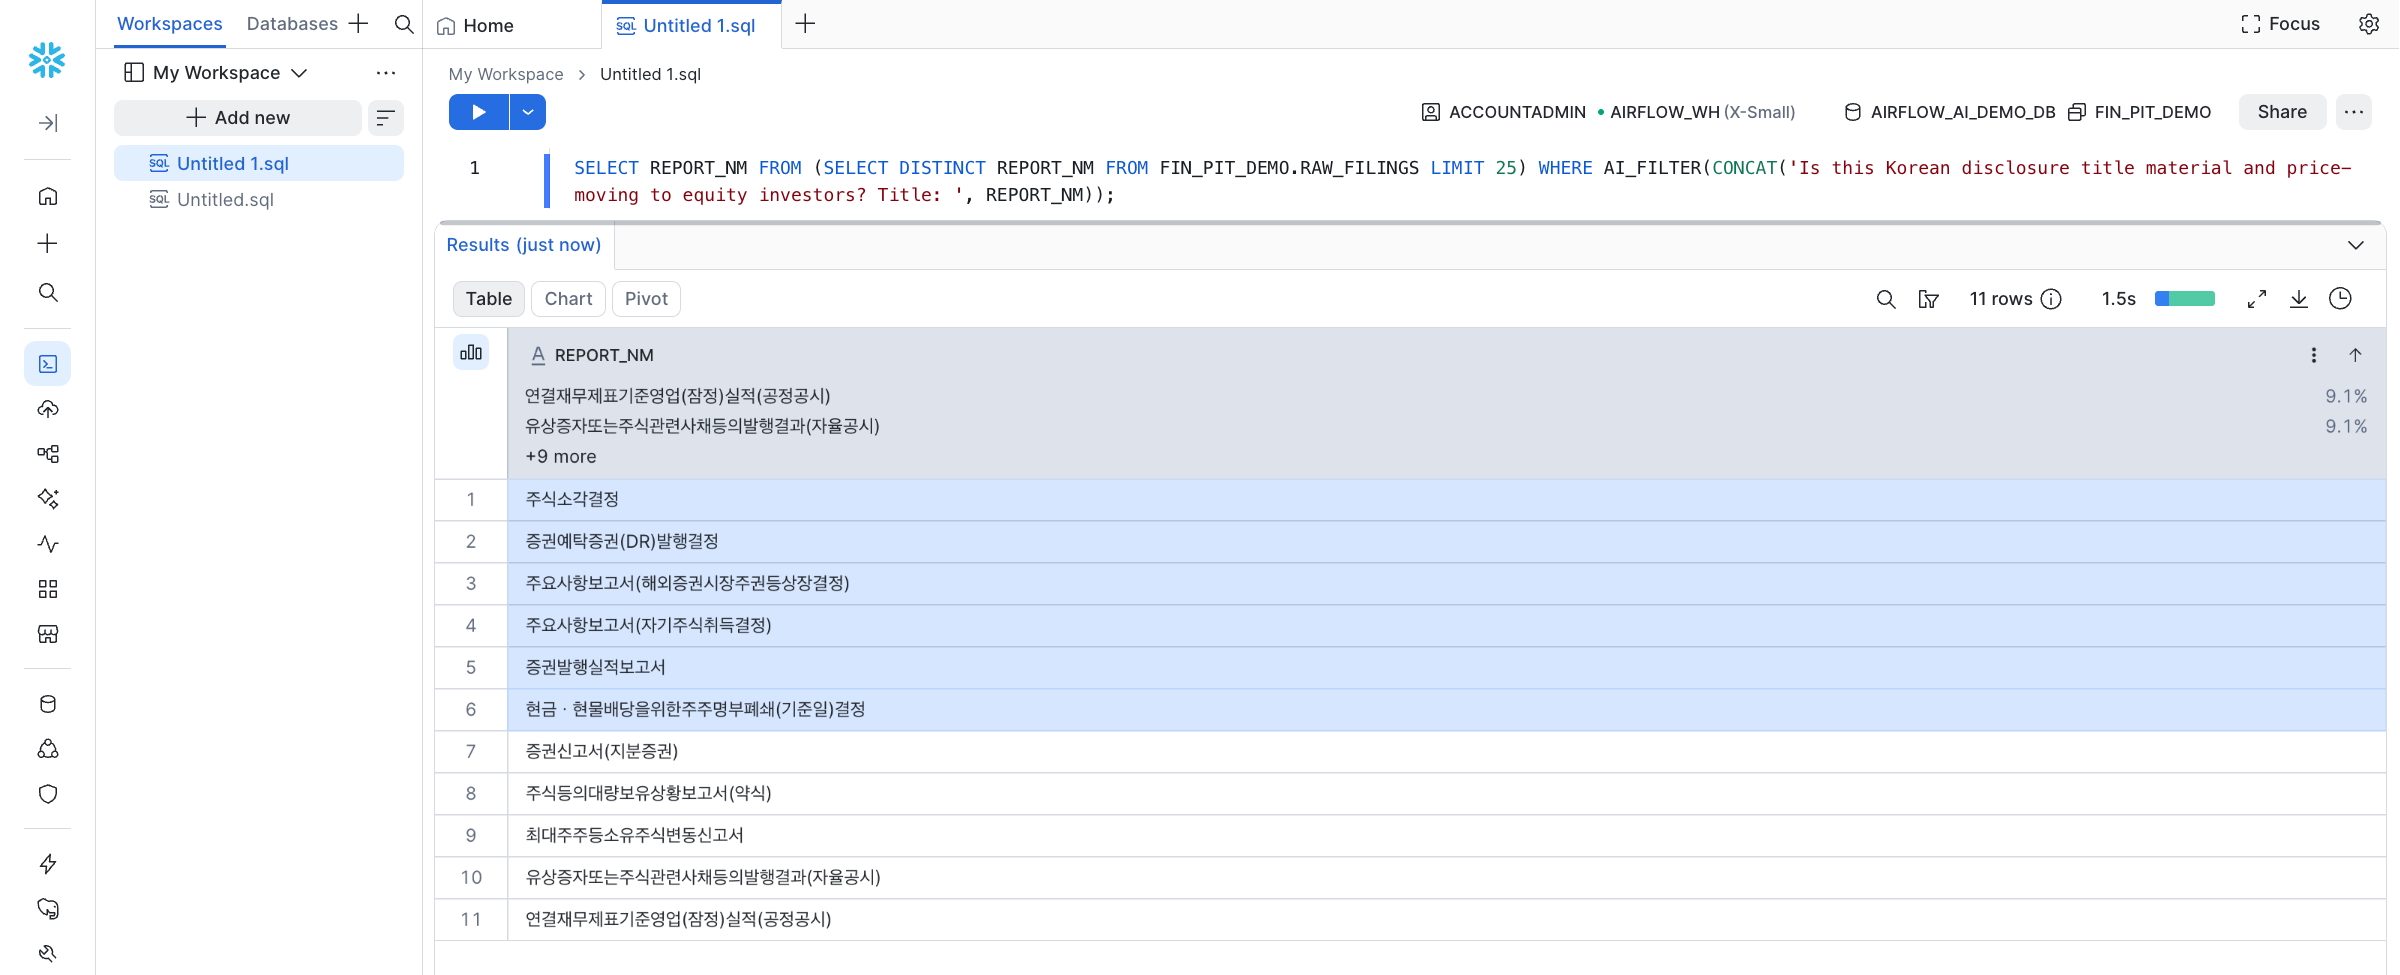
AI_FILTER는 자연어 조건을 WHERE에 그대로 씁니다. 판정이 불리언이라 “주가에 영향 있는 공시만” 같은 조건이 SQL 필터 한 줄이 됩니다.
SELECT REPORT_NM
FROM (SELECT DISTINCT REPORT_NM FROM FIN_PIT_DEMO.RAW_FILINGS LIMIT 25)
WHERE AI_FILTER(CONCAT(
    'Is this Korean disclosure title material and price-moving to equity investors? Title: ',
    REPORT_NM));
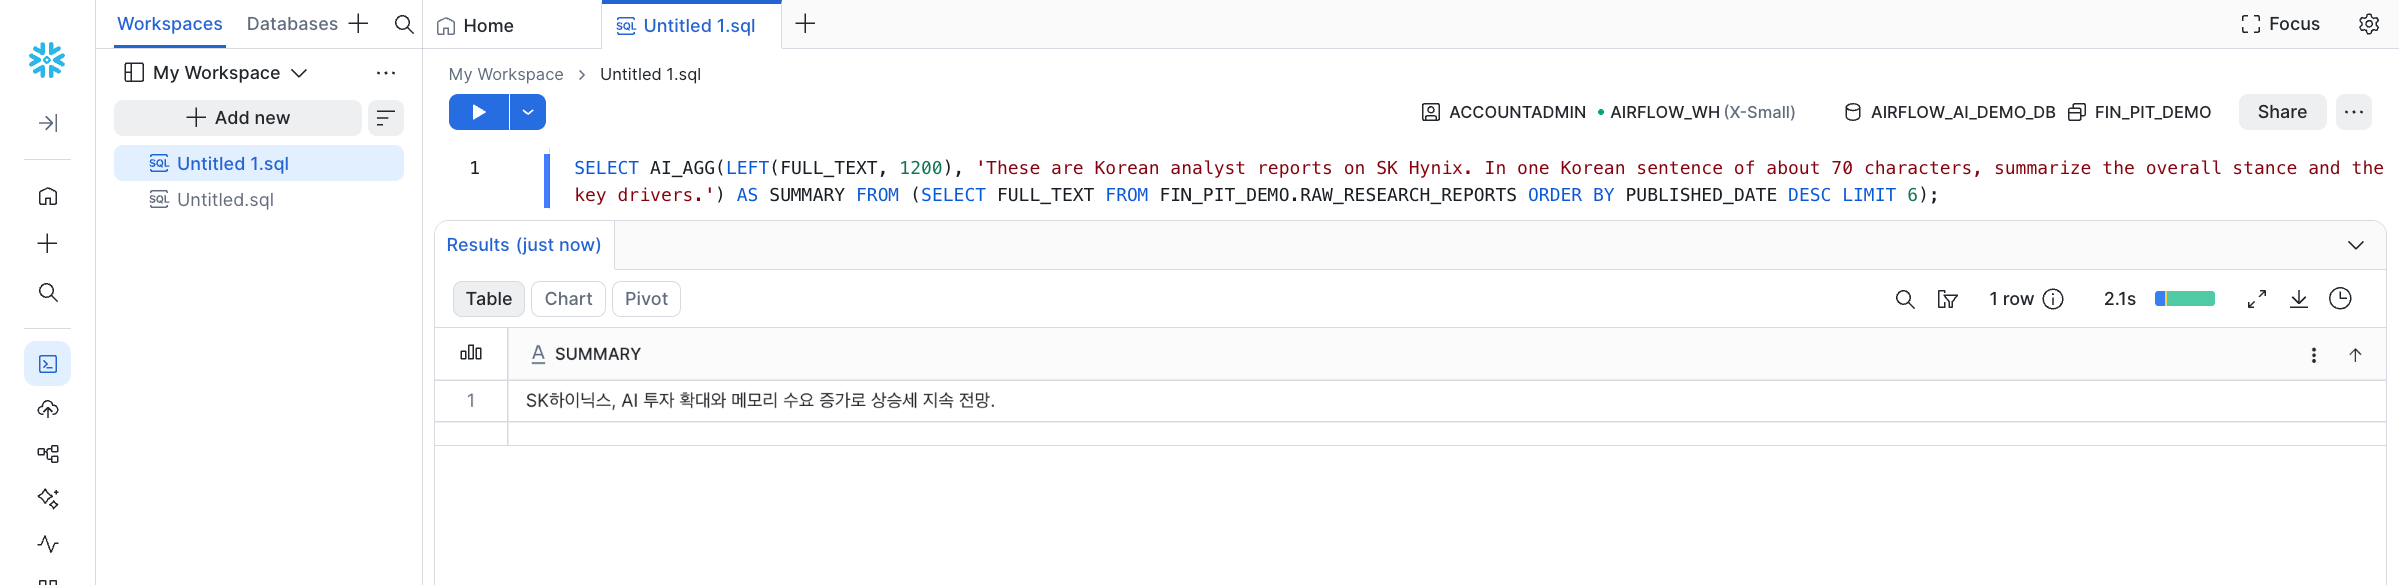
AI_AGG는 행을 가로질러 하나로 묶습니다. 리포트 여러 건을 한 문장으로 압축하는데, 한 건씩 보는 함수로는 못 하는 일이고 컨텍스트 윈도 한계도 타지 않습니다.
SELECT AI_AGG(LEFT(FULL_TEXT, 1200),
    'These are Korean analyst reports on SK Hynix. In one Korean sentence, summarize the overall stance and the key drivers.'
) AS SUMMARY
FROM (SELECT FULL_TEXT FROM FIN_PIT_DEMO.RAW_RESEARCH_REPORTS
      ORDER BY PUBLISHED_DATE DESC LIMIT 6);
AI_REDACT는 텍스트에서 개인정보를 찾아 자리표시자로 바꿉니다. 밖으로 내보내기 전에 이름, 전화, 주소를 가리는 데 쓰는, 이 글의 주제와 정확히 맞닿는 함수입니다.
SELECT AI_REDACT('담당 애널리스트는 홍길동 연구원, 연락처 010-1234-5678, 사무실 서울 영등포구');
-- 담당 애널리스트는 [NAME] 연구원, 연락처 [PHONE_NUMBER], 사무실 [ADDRESS]
AI_SIMILARITY는 두 텍스트의 의미 유사도를 -1~1로 돌려줍니다. 안에서 AI_EMBED가 만든 임베딩 벡터의 코사인 유사도인데, 검색, 군집, 중복 판정의 바탕이 됩니다.
SELECT AI_SIMILARITY('SK하이닉스 목표주가 상향', 'SK Hynix price target raised'),  -- 0.703
       AI_SIMILARITY('SK하이닉스 목표주가 상향', '오늘 점심은 김치찌개');            -- 0.205

SELECT ARRAY_SIZE(AI_EMBED('snowflake-arctic-embed-l-v2.0', 'SK하이닉스 실적')::ARRAY);  -- 1024
이 전용 함수들도 common_functions 태스크에서 한꺼번에 돌립니다.
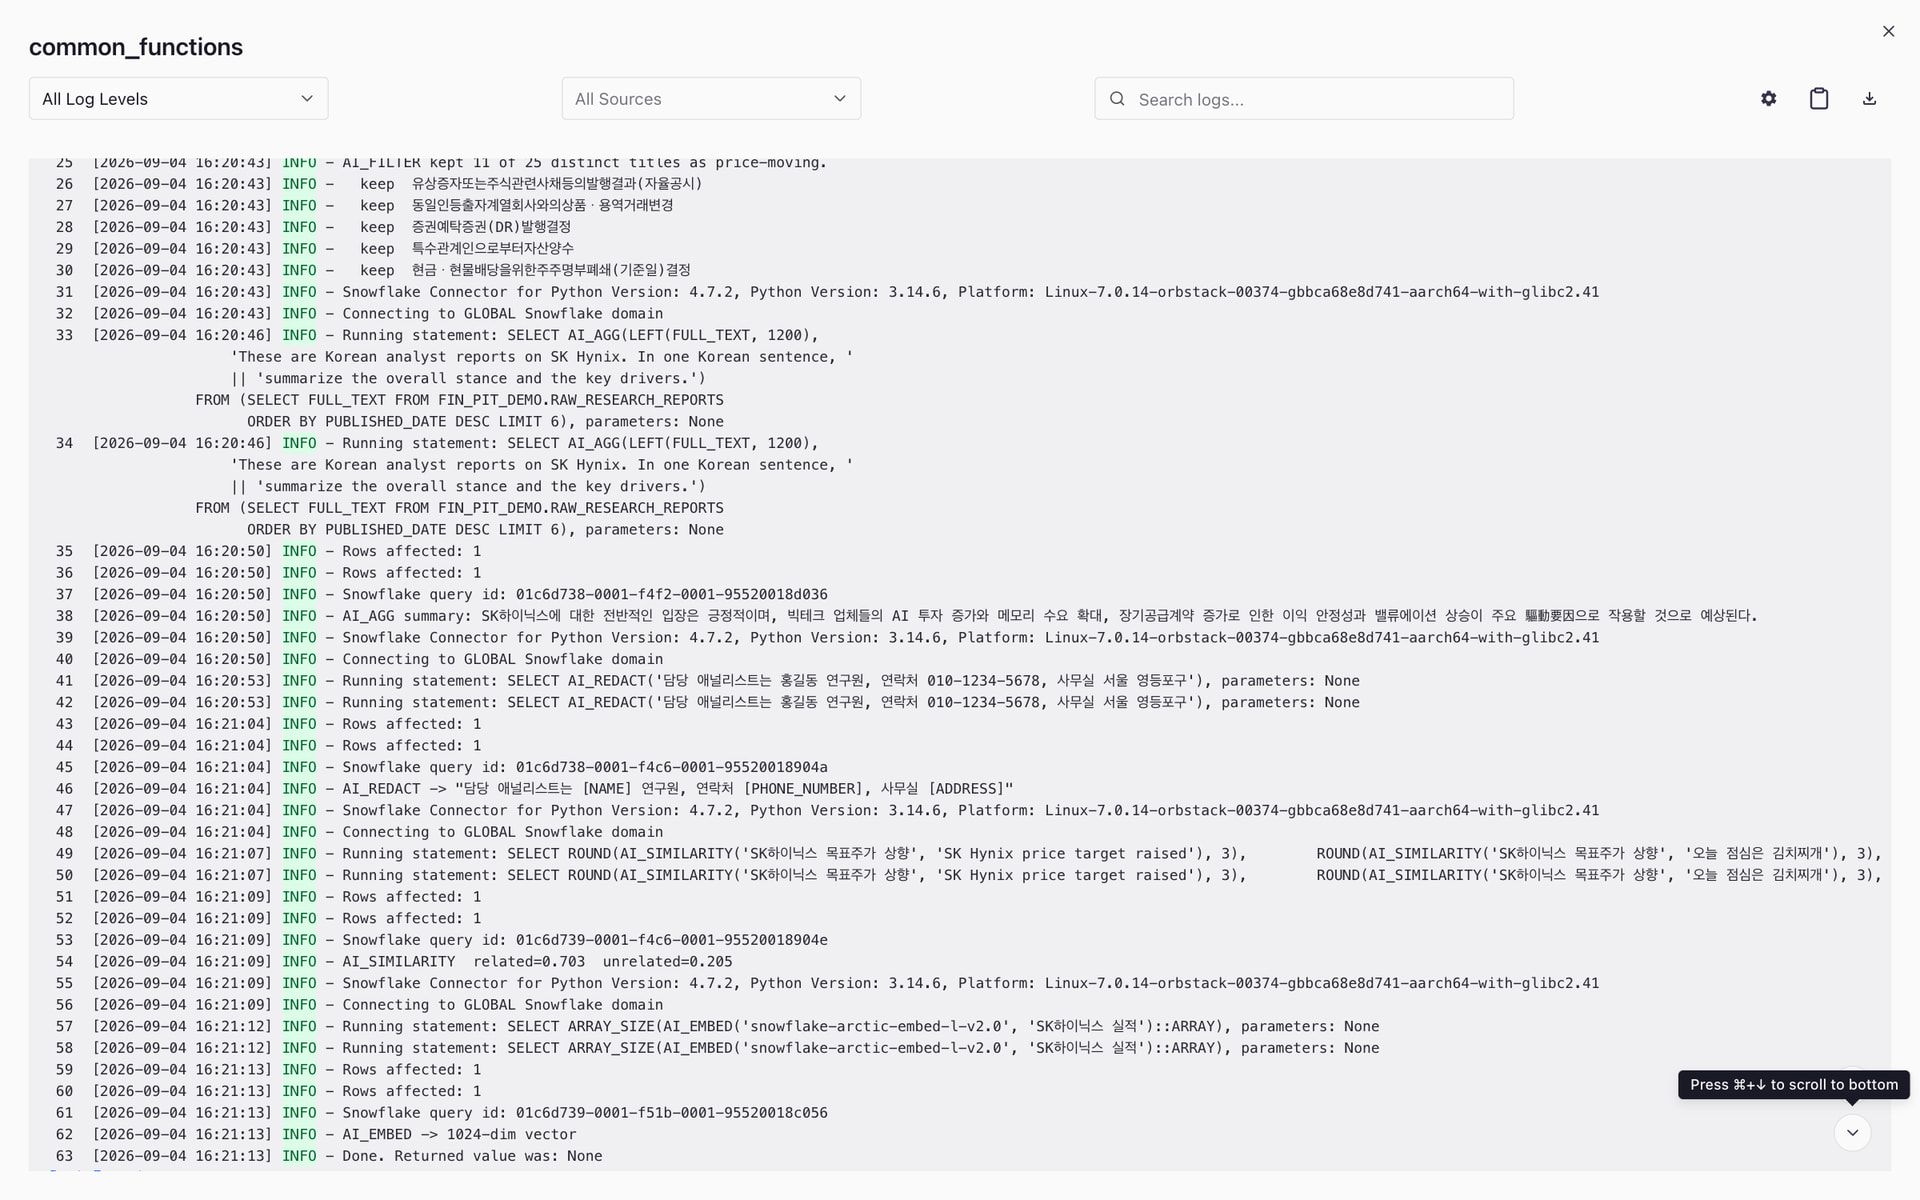
감성(AI_SENTIMENT), 번역(AI_TRANSLATE), 추출(AI_EXTRACT), 음성 전사(AI_TRANSCRIBE)도 같은 방식으로 SQL 안에서 돌아갑니다.
여기까지가 Snowflake Cortex가 잘 맞는 부분들입니다. 서로 독립적인 판정 수천 건을 데이터 옆에서 SQL로 끝내고, 밖으로 못 내보내는 문서는 옮기지 않고 그 자리에서 읽는 일입니다.
직접 해보고 싶으시다면, Cortex AI 함수가 켜진 Snowflake 계정과 Snowflake provider를 붙인 Airflow만 있으면 됩니다. 이 글의 네 단계(스모크 체크, 공시 분류, 리포트 파싱, 전용 함수)를 각각 @task 하나에 담고 전부 SnowflakeHook.run()으로 위 SQL을 보내면 그대로 최소 파이프라인이 됩니다. 라이센스 PDF가 없으면 PARSE_DOCUMENT 단계만 빼고 텍스트를 바로 적재해도 나머지는 똑같이 돌아갑니다.
마무리
데이터가 이미 Snowflake에 있고 그걸 대량으로 분류하거나 추출해야 한다면, 굳이 밖으로 꺼낼 필요가 없습니다. AI_COMPLETE 같은 Cortex AI Functions를 쓰면 SQL 안에서 데이터를 그대로 AI에 넘기고 결과를 다시 테이블에 담습니다.
리서치 리포트처럼 외부로 보내기 어려운 데이터라면 이 방식의 장점이 더 분명해집니다. 데이터가 있는 자리에서 AI를 부르니 Snowflake의 권한과 거버넌스 안에서 처리되고, 모든 호출이 쿼리 기록에 남아 누가 무엇을 언제 넣었는지 나중에 되짚을 수 있습니다.
그리고 Airflow의 역할은 이 때도 달라지지 않습니다. 언제 실행할지, 어떤 작업 다음에 실행할지, 실패하면 어떻게 다시 실행할지, 과거 데이터를 어떻게 백필할지를 관리하는 것입니다. AI를 위해 새로운 오케스트레이터를 도입하는 것이 아니라, 기존 Snowflake 파이프라인에 SQL 태스크 하나를 추가하는 것으로 시작할 수 있습니다.
결국 이제 AI를 잘 쓴다의 기준은 "어느 모델이 좋은가"가 아니라 "우리 도메인의 문제를 더 잘 풀 수 있는가"입니다. 모델 이름은 파라미터 한 줄이라 언제든 갈아 끼우면 그만이고, 그 호출을 데이터 옆에 두고 제때 돌리는 일이 더 오래 남습니다. 그리고 그 오케스트레이션은 이미 Airflow가 하고 있습니다.
Reference
- Snowflake: AI and ML 개요(Cortex 구성)
- Snowflake: Cortex AI Functions(권한, 리전, 서비스 경계)
- Snowflake: Cortex AI Functions 권한과 모델 접근
- Snowflake: Cross-region inference(
CORTEX_ENABLED_CROSS_REGION) - Snowflake: Cortex AI Functions 리전, 모델 가용성
- Snowflake:
AI_COMPLETEstructured outputs - Snowflake:
AI_COMPLETE함수 레퍼런스 - Snowflake:
AI_PARSE_DOCUMENT(LAYOUT모드)